MediaConv v0.6.0: paralelizei o batch e descobri que estava otimizando a coisa errada
Há 19 dias postei aqui sobre o MediaConv, uma CLI em Go que orquestra o FFmpeg.
Na época listei alguns "próximos passos". Dois deles saíram nesta versão:
concorrência no batch e conversão MP4 → WebM.
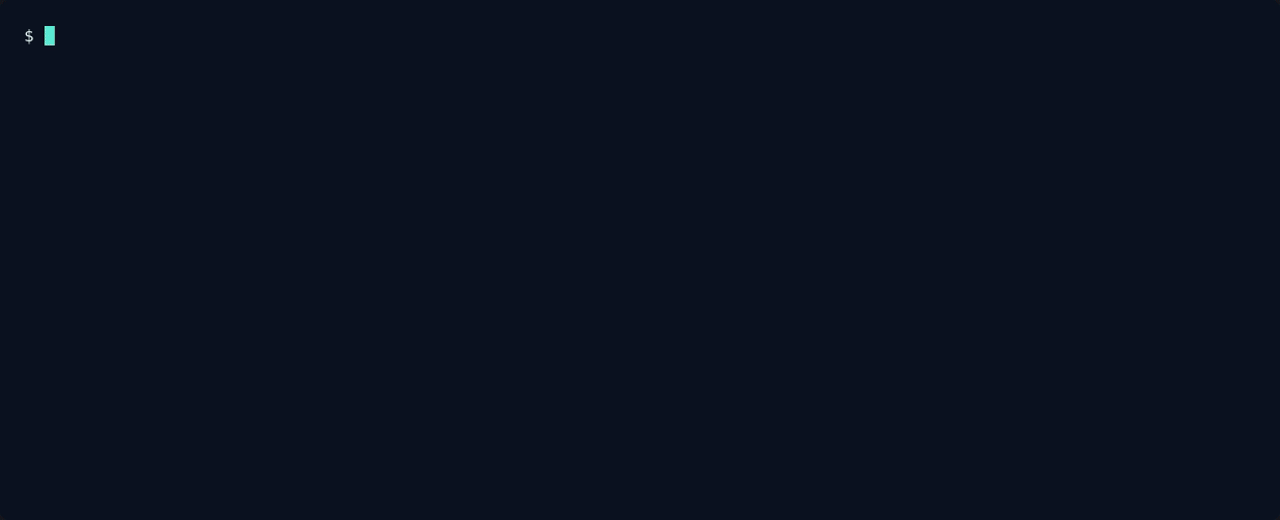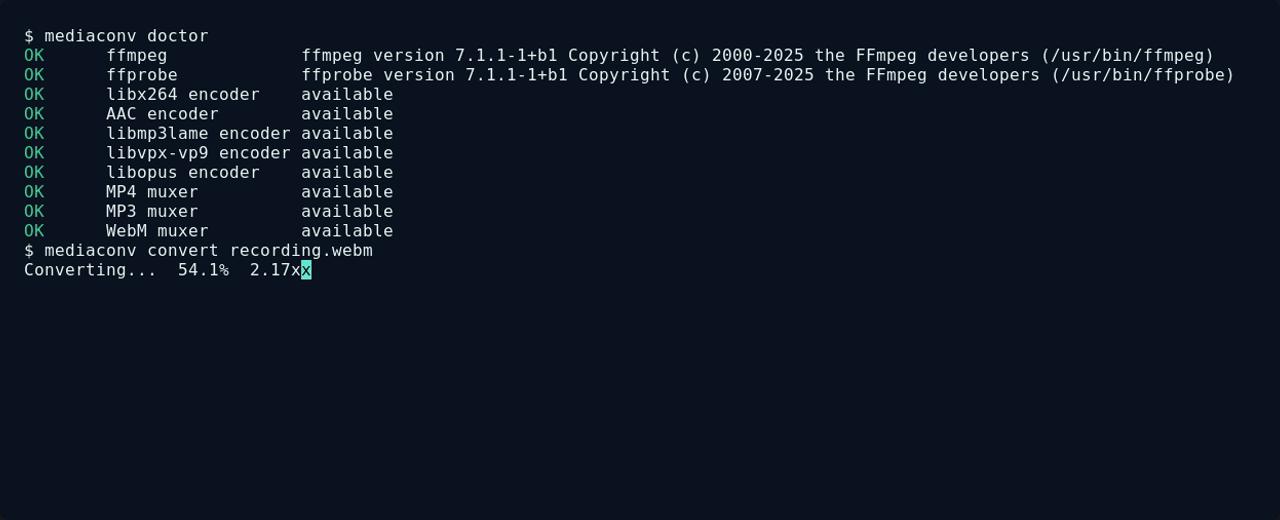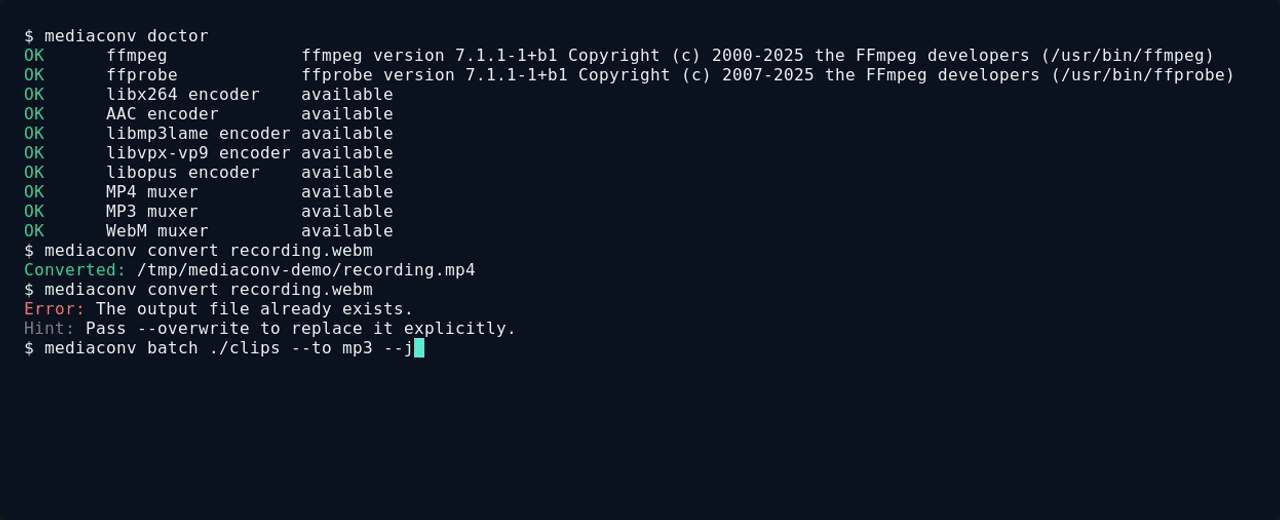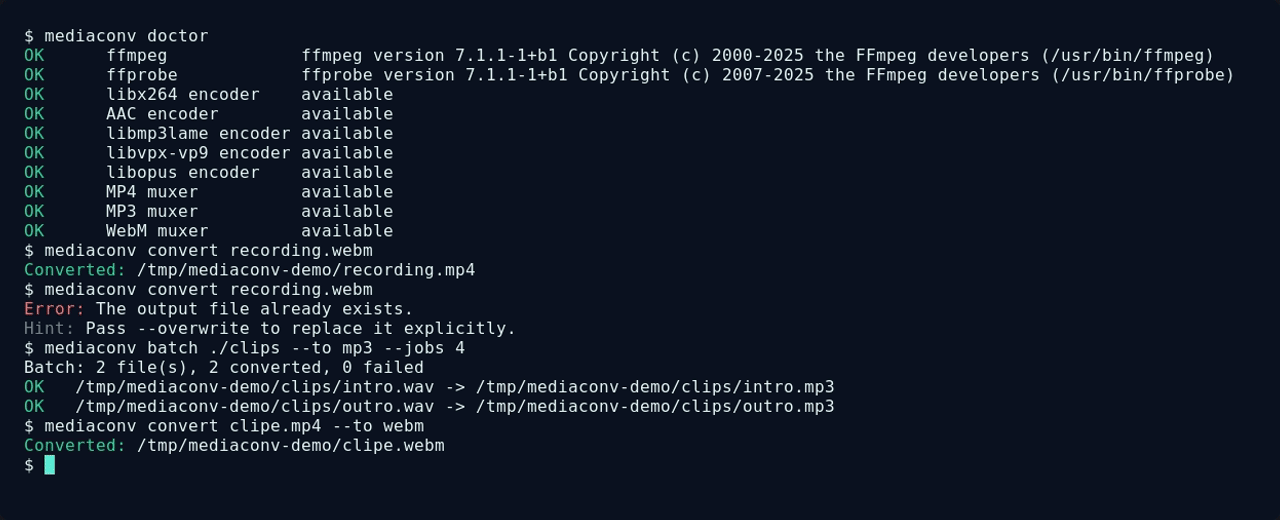
Mas o caminho até o primeiro me ensinou mais do que o resultado.
Eu ia paralelizar antes de medir
O batch convertia um arquivo por vez. A solução óbvia era um pool de workers
e uma flag --jobs.
Antes de escrever, instrumentei: troquei o ffmpeg por um wrapper que registra
cada invocação.
Um lote de 20 arquivos curtos gastava 140 processos:
- 20 conversões (trabalho real)
- 40 ffprobe (validar entrada e saída, 2 por arquivo — correto)
- 80 redetectando as capabilities do FFmpeg
Cada convert refazia ffmpeg -version, ffprobe -version, -encoders e
-muxers. Cerca de 318ms por arquivo. 6,4 dos 11,8 segundos do lote.
Se eu tivesse paralelizado primeiro, teria paralelizado o desperdício.
Memoizei a detecção — uma vez por execução, não por arquivo:
antes:  11,83s   140 processos (80 de detecção)
depois:  5,51s    64 processos (4 de detecção)
Só então o --jobs, em 20 núcleos:
--jobs 1    5,05s
--jobs 2    2,60s
--jobs 4    1,31s
--jobs 8    0,97s
--jobs 16   0,97s
Somando as duas mudanças: 11,83s → 0,97s.
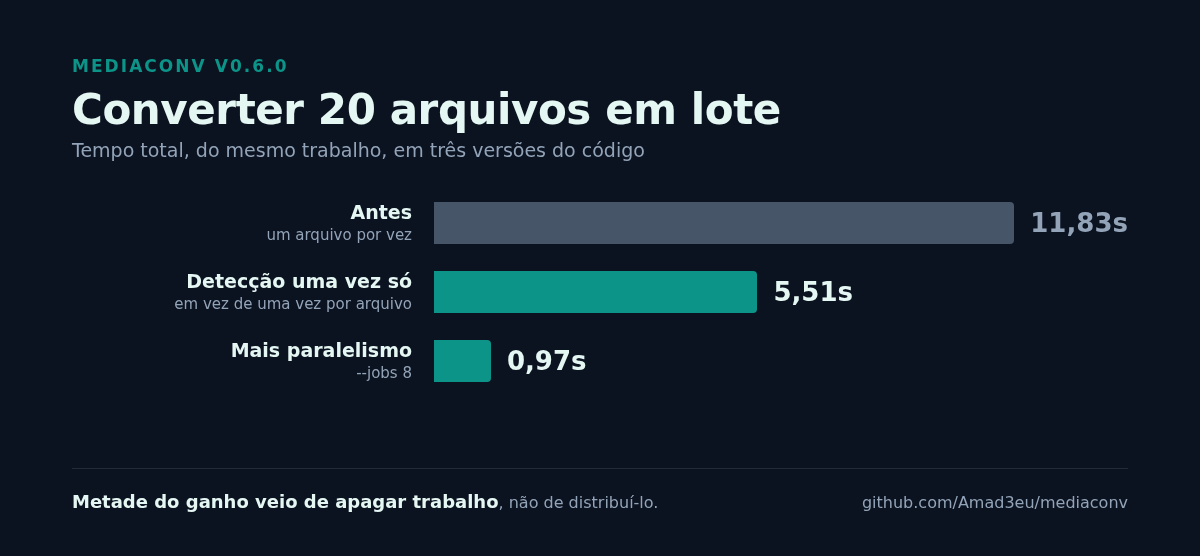
O platô em 8 é real e está documentado: o FFmpeg já usa várias threads por
conversão, então além de certo ponto os jobs só disputam os mesmos núcleos. O
padrão continua 1 — quem não pedir não tem surpresa de CPU.
A decisão que sustenta o paralelismo
Os resultados são coletados por índice do candidato, nunca por ordem de
conclusão. Sem isso, a saída --json viraria não-determinística e qualquer
script que a consome passaria a receber ordens diferentes a cada execução. É o
tipo de bug que só aparece em produção, sob carga, de forma intermitente.
O teste compara as listas inteiras de resultado entre cinco níveis de
concorrência, não só se a contagem bate. Verifiquei que ele tem dentes: troquei
a coleta para ordem de conclusão de propósito e ele falhou já em --jobs 2.
O WebM me contradisse
Adicionei o perfil stream: vídeo para WebM com VP9 e Opus.
Eu ia documentar que WebM gera arquivo menor que H.264 na mesma qualidade — é o
que se repete por aí. Medi antes de afirmar:
| fonte | MP4 | WebM |
|---|---|---|
| ruidosa | 311 KB | 319 KB |
| suave | 55 KB | 63 KB |
Maior nos dois casos. É explicável pelo cenário: reencode curto de material já
comprimido, clipes de 3 segundos, overhead de container. Mas eu não conseguia
sustentar a frase com o que tinha medido.
Então não escrevi. A descrição do perfil agora diz o que é verdade: o motivo de
escolher WebM ali é o codec livre de royalties, e o tamanho depende da fonte.
Documentação que afirma o que não foi verificado também é dívida técnica.
Um bug de CI que talvez esteja no seu repositório
Esse é o item que mais pode ser útil para outras pessoas aqui.
Eu tinha uma ruleset exigindo "todos os checks do workflow CI", e na interface
adicionei um check obrigatório chamado CI.
O GitHub Actions não cria um check com o nome do workflow. Ele cria um por
job. Os contextos reais são Quality checks,
Test (ubuntu-latest, Go 1.27.x), FFmpeg integration, e assim por diante.
Resultado: um check obrigatório que nunca seria reportado. E o pior é que ele
não aparece como falha — aparece como "Expected — Waiting for status to be
reported". Fica amarelo, parecendo fila lenta.
Dois PRs do Dependabot ficaram parados por semanas por causa disso, e eu achava
que era lentidão.
Se você usa ruleset com required status checks, vale conferir o que está
exigido:
gh api repos/OWNER/REPO/rulesets --jq '.[].id' \
  | xargs -I{} gh api repos/OWNER/REPO/rulesets/{} \
    --jq '.rules[] | select(.type=="required_status_checks")
          | .parameters.required_status_checks[].context'
e comparar com os nomes que realmente chegam:
gh api "repos/OWNER/REPO/commits/SHA/check-runs" \
  --jq '.check_runs[].name' | sort -u
Contexto exigido que não apareça na segunda lista nunca vai ser reportado.
O que mais entrou
Saída colorida com --color auto|always|never e respeito a NO_COLOR, com a
decisão tomada por fluxo — redirecionar só o stdout mantém a cor no stderr, e
saída em pipe continua byte a byte idêntica ao que era antes.
Também entrou golangci-lint no CI, e a cobertura do núcleo de orquestração
subiu de 8,9% para 79%.
Próximos passos
Continuam na lista: previews em GIF, saída AAC e WAV, repositórios nativos para
apt/dnf/apk, e hardware acceleration — essa última só depois de existirem testes
confiáveis por capability.
Segue MIT, desenvolvido publicamente: https://github.com/Amad3eu/mediaconv
Se você usa FFmpeg em scripts ou pipelines, a pergunta do post anterior continua
valendo: o que mais incomoda nesse workflow?
E aceito crítica sobre as decisões acima — principalmente sobre manter o
--jobs em 1 por padrão.