E se argumentos pudesse ser traduzidos para uma estrutura computável?
Tenho pensado em uma ideia:
E se fosse possível traduzir um argumento escrito em linguagem natural para uma estrutura que um programa consiga analisar?
Não estou falando de resumir um texto ou descobrir se ele é positivo ou negativo.
A ideia é tentar representar:
como o argumento daquele texto funciona.
Por exemplo:
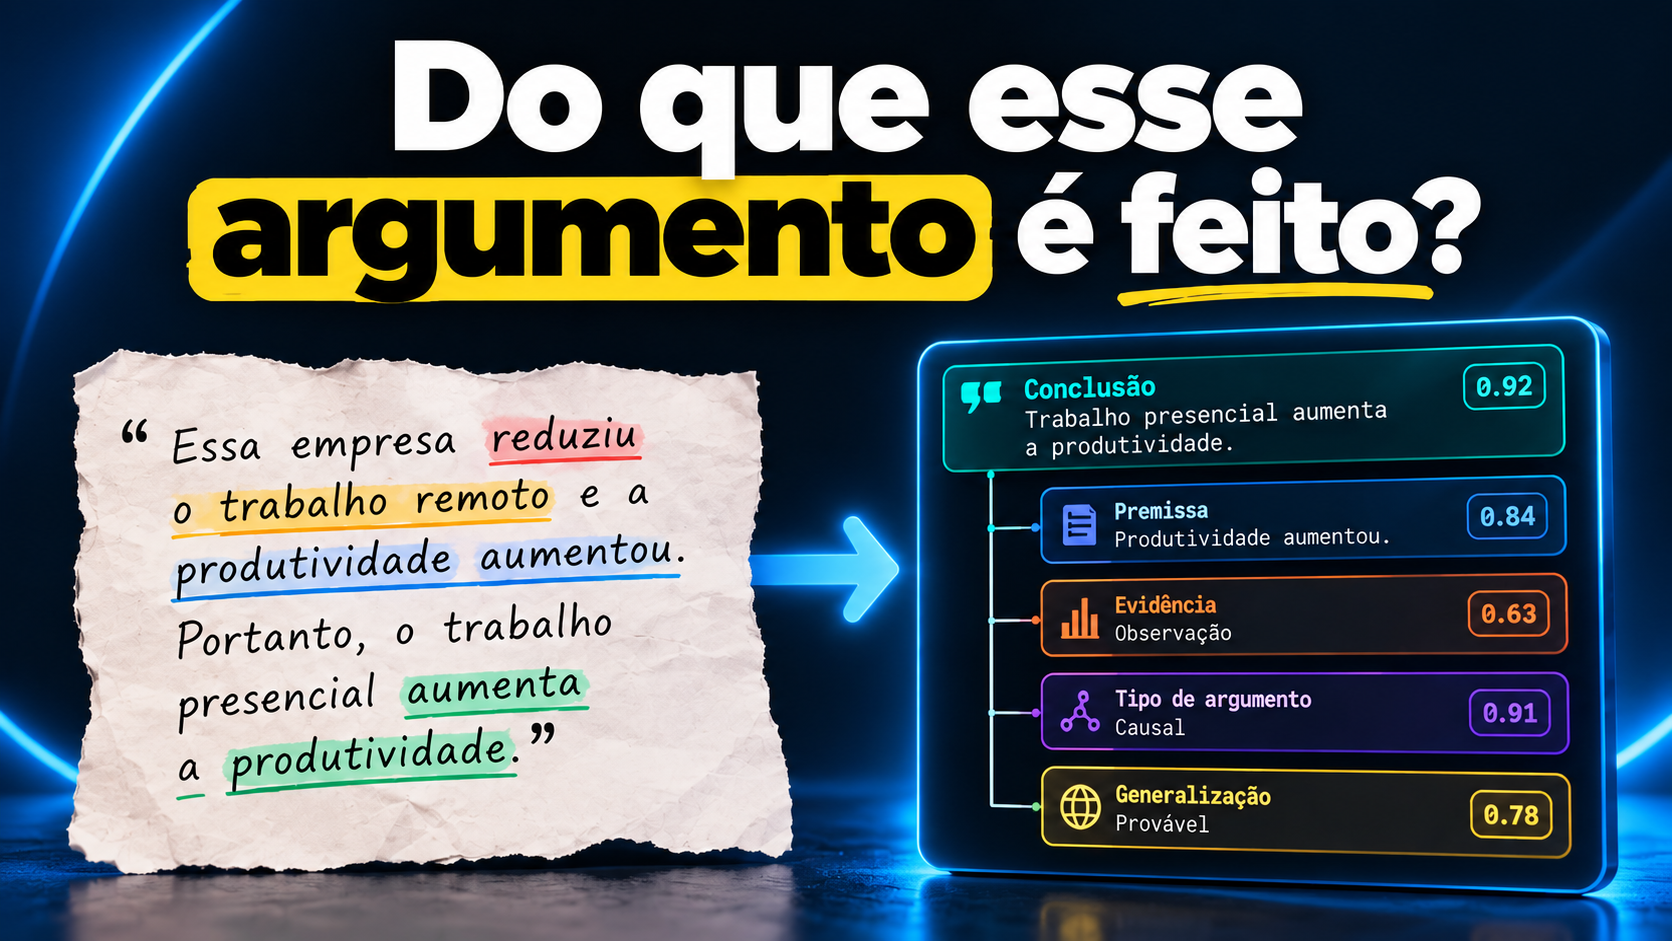
“Essa empresa reduziu o trabalho remoto e a produtividade aumentou. Portanto, trabalho presencial aumenta a produtividade.”
Um sistema poderia olhar para esse trecho e representar algumas características:
tipo da afirmação: causal
papel: conclusão
evidência apresentada: observação
generalização: provável
premissa implícita: presente
Ou até trabalhar com graus de confiança:
causal:              0.91
conclusão:           0.95
generalização:       0.78
premissa implícita:  0.84
evidência empírica:  0.42
O objetivo não seria decidir automaticamente se o argumento é verdadeiro ou falso.
Seria primeiro responder uma pergunta mais básica:
“Do que esse argumento é feito?”
Por que isso me interessa?
Hoje conseguimos processar enormes quantidades de informações, inclusive muitas vezes enviesadas e falsas, mas existe uma diferença entre identificar o que alguém disse e identificar como aquela pessoa chegou à conclusão, o que ela quis transmitir com aquele texto, e com aquela conclusão.
Essa área já existe na pesquisa e é conhecida como Argument Mining.
Lawrence e Reed definem Argument Mining como a identificação automática da estrutura de inferência e raciocínio presente em argumentos escritos em linguagem natural.
Pesquisas nessa área trabalham, por exemplo, com:
claim
premise
evidence
support
attack
Ou seja, não estou partindo do zero.
Uma referência ainda mais antiga é o modelo de argumentação de Stephen Toulmin.
Toulmin divide argumentos em elementos como:
Claim   → o que está sendo afirmado
Grounds → evidências utilizadas
Warrant → princípio que liga a evidência à conclusão
Backing → suporte para esse princípio
Qualifier → grau de certeza
Rebuttal → situações em que a conclusão pode não valer
O interessante é que o warrant muitas vezes não aparece explicitamente no texto. Ele é uma suposição necessária para que o argumento faça sentido.
É exatamente esse tipo de coisa que gostaria de explorar computacionalmente.
Onde entra IA?
O lançamento recente do Jev, da TypeSafe AI, chamou minha atenção porque ele trabalha de forma diferente de um chatbot tradicional.
Em vez de necessariamente gerar uma resposta em texto, ele recebe informação não estruturada e responde perguntas previamente definidas através de
decisões tipadas acompanhadas de probabilidades.
A própria TypeSafe descreve a ideia como:
unstructured state → typed probabilistic decisions
e apresenta Jev para tarefas como classificação, scoring, extração e branching dentro de software.
Isso sugere algo interessante.
Talvez eu não precise construir um modelo de IA.
Talvez o problema mais interessante seja construir a linguagem que descreve um argumento.
Por exemplo:
Argumento
├── tipo
│   ├── factual
│   ├── causal
│   ├── normativo
│   └── definicional
│
├── função
│   ├── premissa
│   ├── conclusão
│   ├── evidência
│   └── objeção
│
└── operação
    ├── comparação
    ├── generalização
    ├── analogia
    └── inferência causal
O primeiro desafio seria justamente descobrir se essa classificação faz sentido.
Para que isso serviria?
Imagine algumas aplicações.
Um leitor poderia visualizar:
Conclusão
   ↑
Premissa
   ↑
Evidência
e perceber rapidamente onde está o ponto central de um argumento.
Em debates, seria possível comparar duas posições e descobrir que elas talvez nem discordem da conclusão, mas partam de premissas diferentes.
Em textos acadêmicos, um sistema poderia ajudar a localizar afirmações que não apresentam evidências suficientes.
Em ferramentas educacionais, estudantes poderiam aprender argumentação vendo seus próprios textos transformados em estruturas.
Em sistemas de busca, em vez de procurar apenas textos sobre determinado assunto, poderíamos procurar:
“argumentos causais que utilizam estatísticas para sustentar determinada conclusão”.
Também seria possível estudar grandes volumes de notícias, artigos, fóruns ou documentos e perguntar não apenas:
“Sobre o que as pessoas estão falando?”
mas:
“Que tipos de argumentos estão sendo usados?”
O problema
Isso rapidamente vira um projeto enorme.
Argumentação envolve lógica, linguística, filosofia, NLP, psicologia cognitiva e ciência da computação.
Então minha intenção inicial seria muito menor:
1. estudar modelos existentes de argumentação
2. definir poucas categorias
3. criar exemplos manualmente
4. testar ambiguidades
5. construir um schema simples
6. testar classificadores como Jev
7. revisar a taxonomia
Talvez começar com apenas 5 ou 6 dimensões.
Nada de tentar construir uma “máquina que entende qualquer argumento”.
Primeiro quero descobrir se conseguimos criar uma representação pequena, útil e consistente.
Estou publicando isso porque provavelmente existem pessoas de áreas diferentes que enxergariam problemas nessa ideia que eu não consigo enxergar sozinho.
Se você trabalha ou estuda NLP, Argument Mining, IA, lógica, linguística, filosofia da linguagem, representação de conhecimento ou áreas próximas, gostaria muito de trocar ideias.
Principalmente sobre uma pergunta:
Quais propriedades mínimas precisamos representar para transformar um argumento em algo computável sem destruir seu significado?
Referências iniciais:
- Lawrence & Reed — Argument Mining: A Survey, Computational Linguistics, 2019.
- Stephen Toulmin — modelo de argumentação: claim, grounds, warrant, backing, qualifier e rebuttal. Uma introdução acessível está disponível no Purdue OWL.
- TypeSafe AI — Introducing System One Models & Jev, publicado em 15 de setembro de 2026.
Ainda é uma ideia em estágio inicial. Justamente por isso estou procurando pessoas interessadas em pensar nela comigo.