Pitch: Três perguntas para decidir se você precisa mesmo de um agente de IA (ou se um classificador de intenções resolve)
O exemplo é ilustrativo, mas talvez você já tenha recebido um pedido parecido: "coloca um agente de IA pra responder o WhatsApp da loja". Dá pra montar isso em uma tarde. Um modelo, algumas ferramentas (consultar pedido, gerar segunda via, abrir troca) e um prompt com as regras. Na demo, funciona.
Agora imagine o mesmo prompt alguns meses depois, cheio de regras como "SEMPRE consulte o pedido antes de responder" e "NUNCA gere segunda via de pedido cancelado". Leia essas regras juntas e repare que cada uma descreve um passo que você já conhecia antes da primeira mensagem chegar. Você escreveu o caminho em linguagem natural e está pagando um modelo para reler esse caminho a cada conversa e, quase sempre, segui-lo. O problema mora nesse "quase sempre".
O que conta como agente
Uma definição curta: agente é um sistema em que o modelo decide o próximo passo. Se quem escolhe o próximo passo é o seu código, e o modelo só gera conteúdo (extrai um campo, escreve uma resposta, escolhe um rótulo), você não tem um agente. Isso é uma boa notícia, porque o que o seu código decide você consegue testar.
Entre uma chamada ao modelo e um agente existem degraus, e cada degrau acima tira uma decisão do seu código e entrega ao modelo:
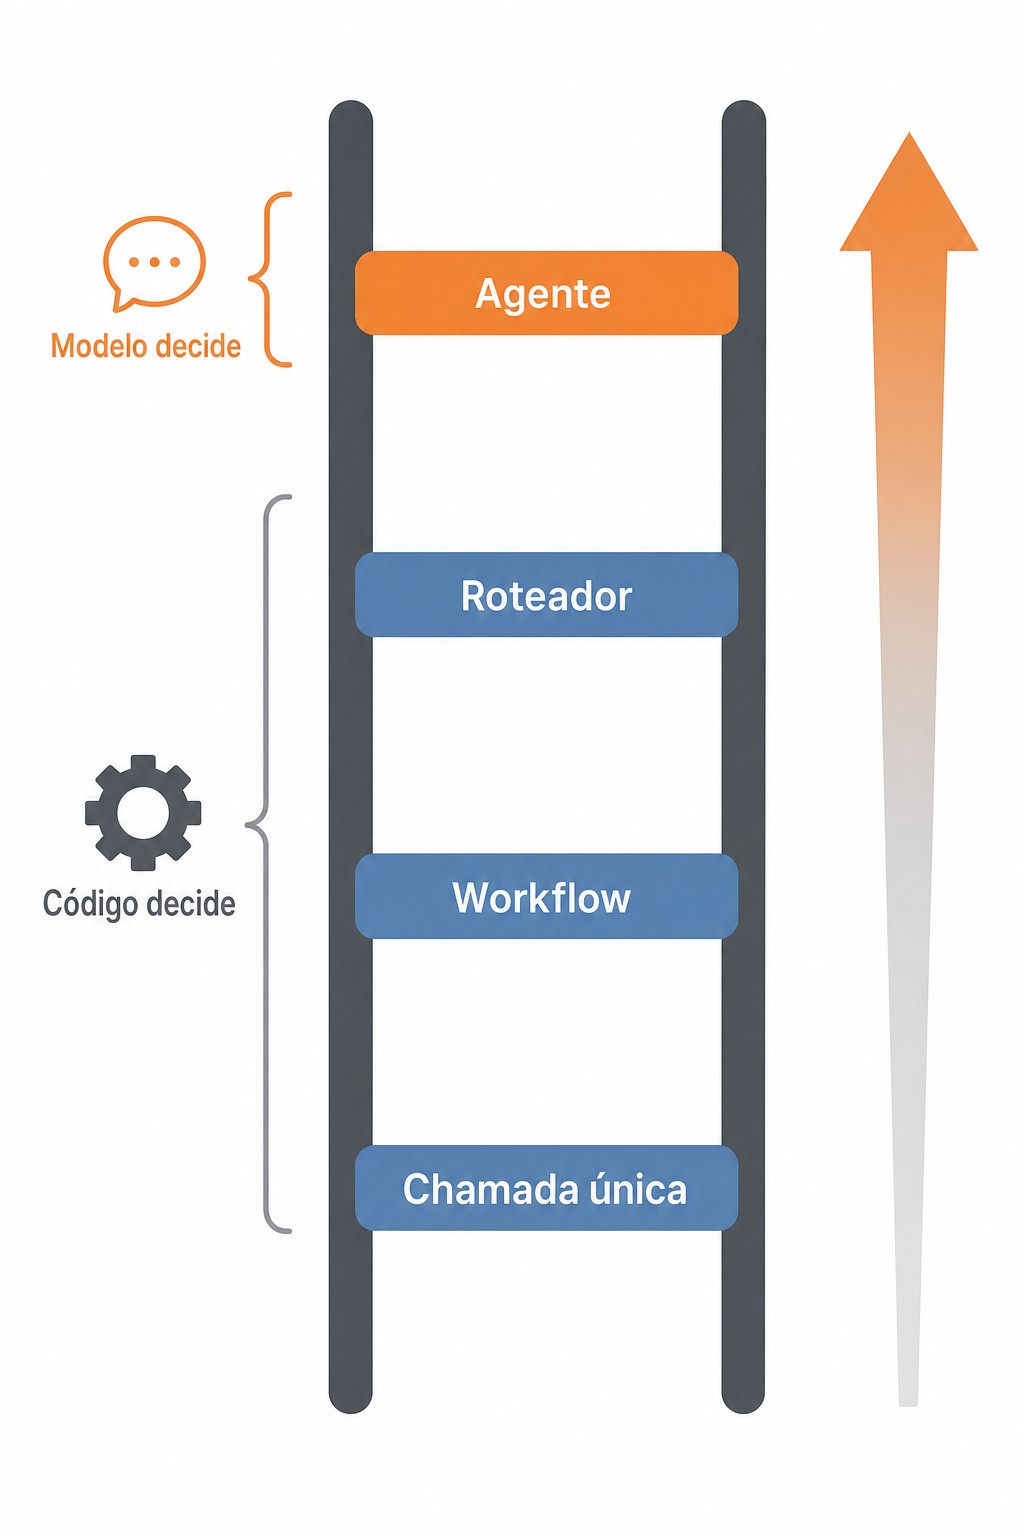
| Degrau | Quem decide o próximo passo | No WhatsApp da loja (ilustrativo) |
|---|---|---|
| Chamada única | Seu código | Extrair o número do pedido da mensagem |
| Workflow fixo | Seu código, numa ordem fixa | Consultar o pedido, montar a resposta, enviar |
| Roteador | O modelo escolhe uma rota de uma lista que você escreveu, e o código assume a partir daí | "Isso é status, segunda via, troca ou outra coisa?" |
| Agente | O modelo, a cada passo | Descobrir por que um Pix pago não deu baixa no pedido |
Se você já fez um chatbot, o roteador é o velho classificador de intenções: o modelo escolhe uma intenção de uma lista fechada e o seu código chama o handler correspondente. E antes do primeiro degrau vem o código puro: se uma regex ou uma tabela resolve, nem chame o modelo.
Três perguntas antes de subir de degrau
Avalie a tarefa com estas três perguntas, nesta ordem:
- Dá pra escrever os passos antes da mensagem chegar? Se sim, escreva em código, como uma chamada única ou um workflow. Se existem alguns caminhos conhecidos e a única dúvida é qual deles vale para esta entrada, use um roteador. Agente só entra quando cada passo depende do resultado do anterior.
- Quanto custa um passo errado? Consultar o pedido errado custa quase nada. Estornar o Pix errado dá trabalho para desfazer. Deixe o modelo explorar onde errar é barato e exija aprovação humana no código para o que mexe com dinheiro. Uma regra no prompt só diminui a chance.
- Algo fora do modelo consegue dizer se a saída está certa? Pode ser um teste ou um valor que tem que bater com o extrato. Se só uma pessoa lendo conversa por conversa consegue julgar, você paga a pessoa e o agente.
Aplicando no WhatsApp da loja
No exemplo, a maior parte das mensagens cai em poucos tipos conhecidos: status do pedido (consulta e resposta padrão), segunda via (gerar o boleto ou o código Pix e mandar) e troca (conferir o prazo e abrir um chamado). Dá pra escrever todos esses caminhos em código hoje. A única incógnita é que tipo de mensagem chegou, e responder isso uma vez, na entrada, é o trabalho do roteador. O que ele não souber classificar vai para uma pessoa.
Uma rota é diferente: "paguei e o pedido continua aguardando pagamento". A causa pode ser um Pix com valor diferente, um webhook do gateway que não chegou, um pedido duplicado ou um pagamento que caiu em outro pedido, e o que você consulta em seguida depende do que a última consulta mostrou. Essa rota passa nas três perguntas: o caminho é desconhecido, uma consulta errada custa pouco e dá pra verificar o resultado, já que no fim o pagamento precisa bater com algum pedido. Ali vale usar um agente, com uma condição: ele lê o que quiser, mas estorno e baixa manual esperam uma pessoa.
Como montar o roteador sem se enganar
Um esboço em Python. classificar() é a chamada ao modelo com saída estruturada, e o resto é código comum:
ROTAS = {
    "status_pedido": responder_status,
    "segunda_via": enviar_segunda_via,
    "troca": abrir_troca,
    "pagamento_nao_confirmado": agente_pagamento,  # a única rota com agente
}

def rotear(msg):
    # classificar() devolve o nome da rota como string. O schema da
    # resposta limita esse campo às chaves de ROTAS mais "incerto".
    a = classificar(msg, prompt=PROMPT_A)
    b = classificar(msg, prompt=PROMPT_B)
    registrar(msg, a, b)

    # discordância, "incerto" ou rota inventada: vai para uma pessoa
    if a != b or a not in ROTAS:
        return passar_para_humano(msg)
    return ROTAS[a](msg)
Cada linha ali existe por um motivo:
Lista fechada. Com um enum no JSON Schema e uma API que force o schema na geração (structured outputs no modo estrito), o modelo não consegue inventar uma rota. Sem essa garantia, o a not in ROTAS cobre o buraco. Em qualquer caso, o modelo ainda pode escolher a rota errada, e é para isso que serve o resto.
Uma rota chamada "incerto". Se a dúvida não tiver para onde ir, vira chute em uma rota qualquer.
Um sinal de dúvida que não seja escrito pelo modelo. Se a sua API devolve logprobs, some os logprobs dos tokens do rótulo escolhido e use isso como confiança. Se não devolve, rode a classificação duas vezes e trate discordância como dúvida. Use prompts diferentes nas duas chamadas: com o mesmo prompt e temperatura zero, as respostas tendem a sair iguais e o teste não mede nada. Isso dobra o custo da classificação, então use só onde uma rota errada sai caro. E um campo "confiança": 0.95 que o próprio modelo coloca na resposta é só mais texto gerado.
Rota fora da lista vai para uma pessoa. O erro clássico é ROTAS.get(rota, rota_padrao). No dia em que uma mudança de prompt fizer o modelo responder "cobrança", uma palavra que faz sentido mas não existe na sua lista, tudo cai na rota padrão e ninguém percebe. Mande para uma pessoa e conte quantas vezes acontece.
Meça como classificador. Separe um lote de mensagens reais, anonimizadas, rotule à mão e conte os acertos por rota. Olhe também a calibração: das mensagens que o roteador classificou com alta confiança, quantas estavam certas? Comece pelos erros cometidos com mais confiança, porque são esses que o seu código executa sem hesitar. Refaça a medição sempre que mudar o modelo, o prompt ou a lista de rotas.
Quando essa conta muda
A linha entre os degraus muda a cada geração de modelos. Um roteador com rotas implementadas em código fixo continua valendo, mas um roteador que escolhe entre vários agentes especialistas pode acabar sendo substituído por um único agente com boas ferramentas. A cada troca de modelo, teste de novo o desenho mais simples num conjunto de casos reais com resposta conhecida.
O livro por trás deste post
Sou o Nir Diamant. Meus repositórios open source de IA no GitHub, como o RAG_Techniques e o GenAI_Agents, somam mais de 85 mil estrelas. A escada, as três perguntas e os cuidados com o roteador vêm dos capítulos 1 e 3 do meu livro AI Agents Made Simple: Um guia de decisão para criar agentes de IA que funcionam, que saiu em português.
São 28 capítulos, cada um sobre um padrão de design de agentes (do loop básico a evals, guardrails e multiagente), e todos respondem às mesmas quatro perguntas: como funciona, o que dá errado, quanto custa e quando é exagero. O livro não tem código e não cita framework nem fornecedor, para continuar valendo quando a ferramenta da moda mudar.
Não falo português, então usei IA tanto na tradução do livro (a partir do original em inglês, com um glossário fixo de termos técnicos) quanto neste texto. Se algum termo soar estranho, me avise nos comentários.
A edição Kindle custa R$ 5,99 na primeira semana e depois passa para R$ 29,90.
https://www.amazon.com.br/dp/B0HPMK29RN
Para quem já tem um bot com IA em produção no WhatsApp: vocês medem a acurácia do roteamento, ou descobrem a rota errada quando o cliente reclama?