Seu LLM acerta? Meça por amostra, não pelo painel
Num comparador de listas de preço de fornecedores que entreguei a um supermercado na Argentina, a IA lê cada cartão de dúvida antes de uma pessoa abrir e deixa uma decisão com o porquê: «é este», «não é», «dúvida» ou «vale para vários». Foram dezenas de milhares de decisões.
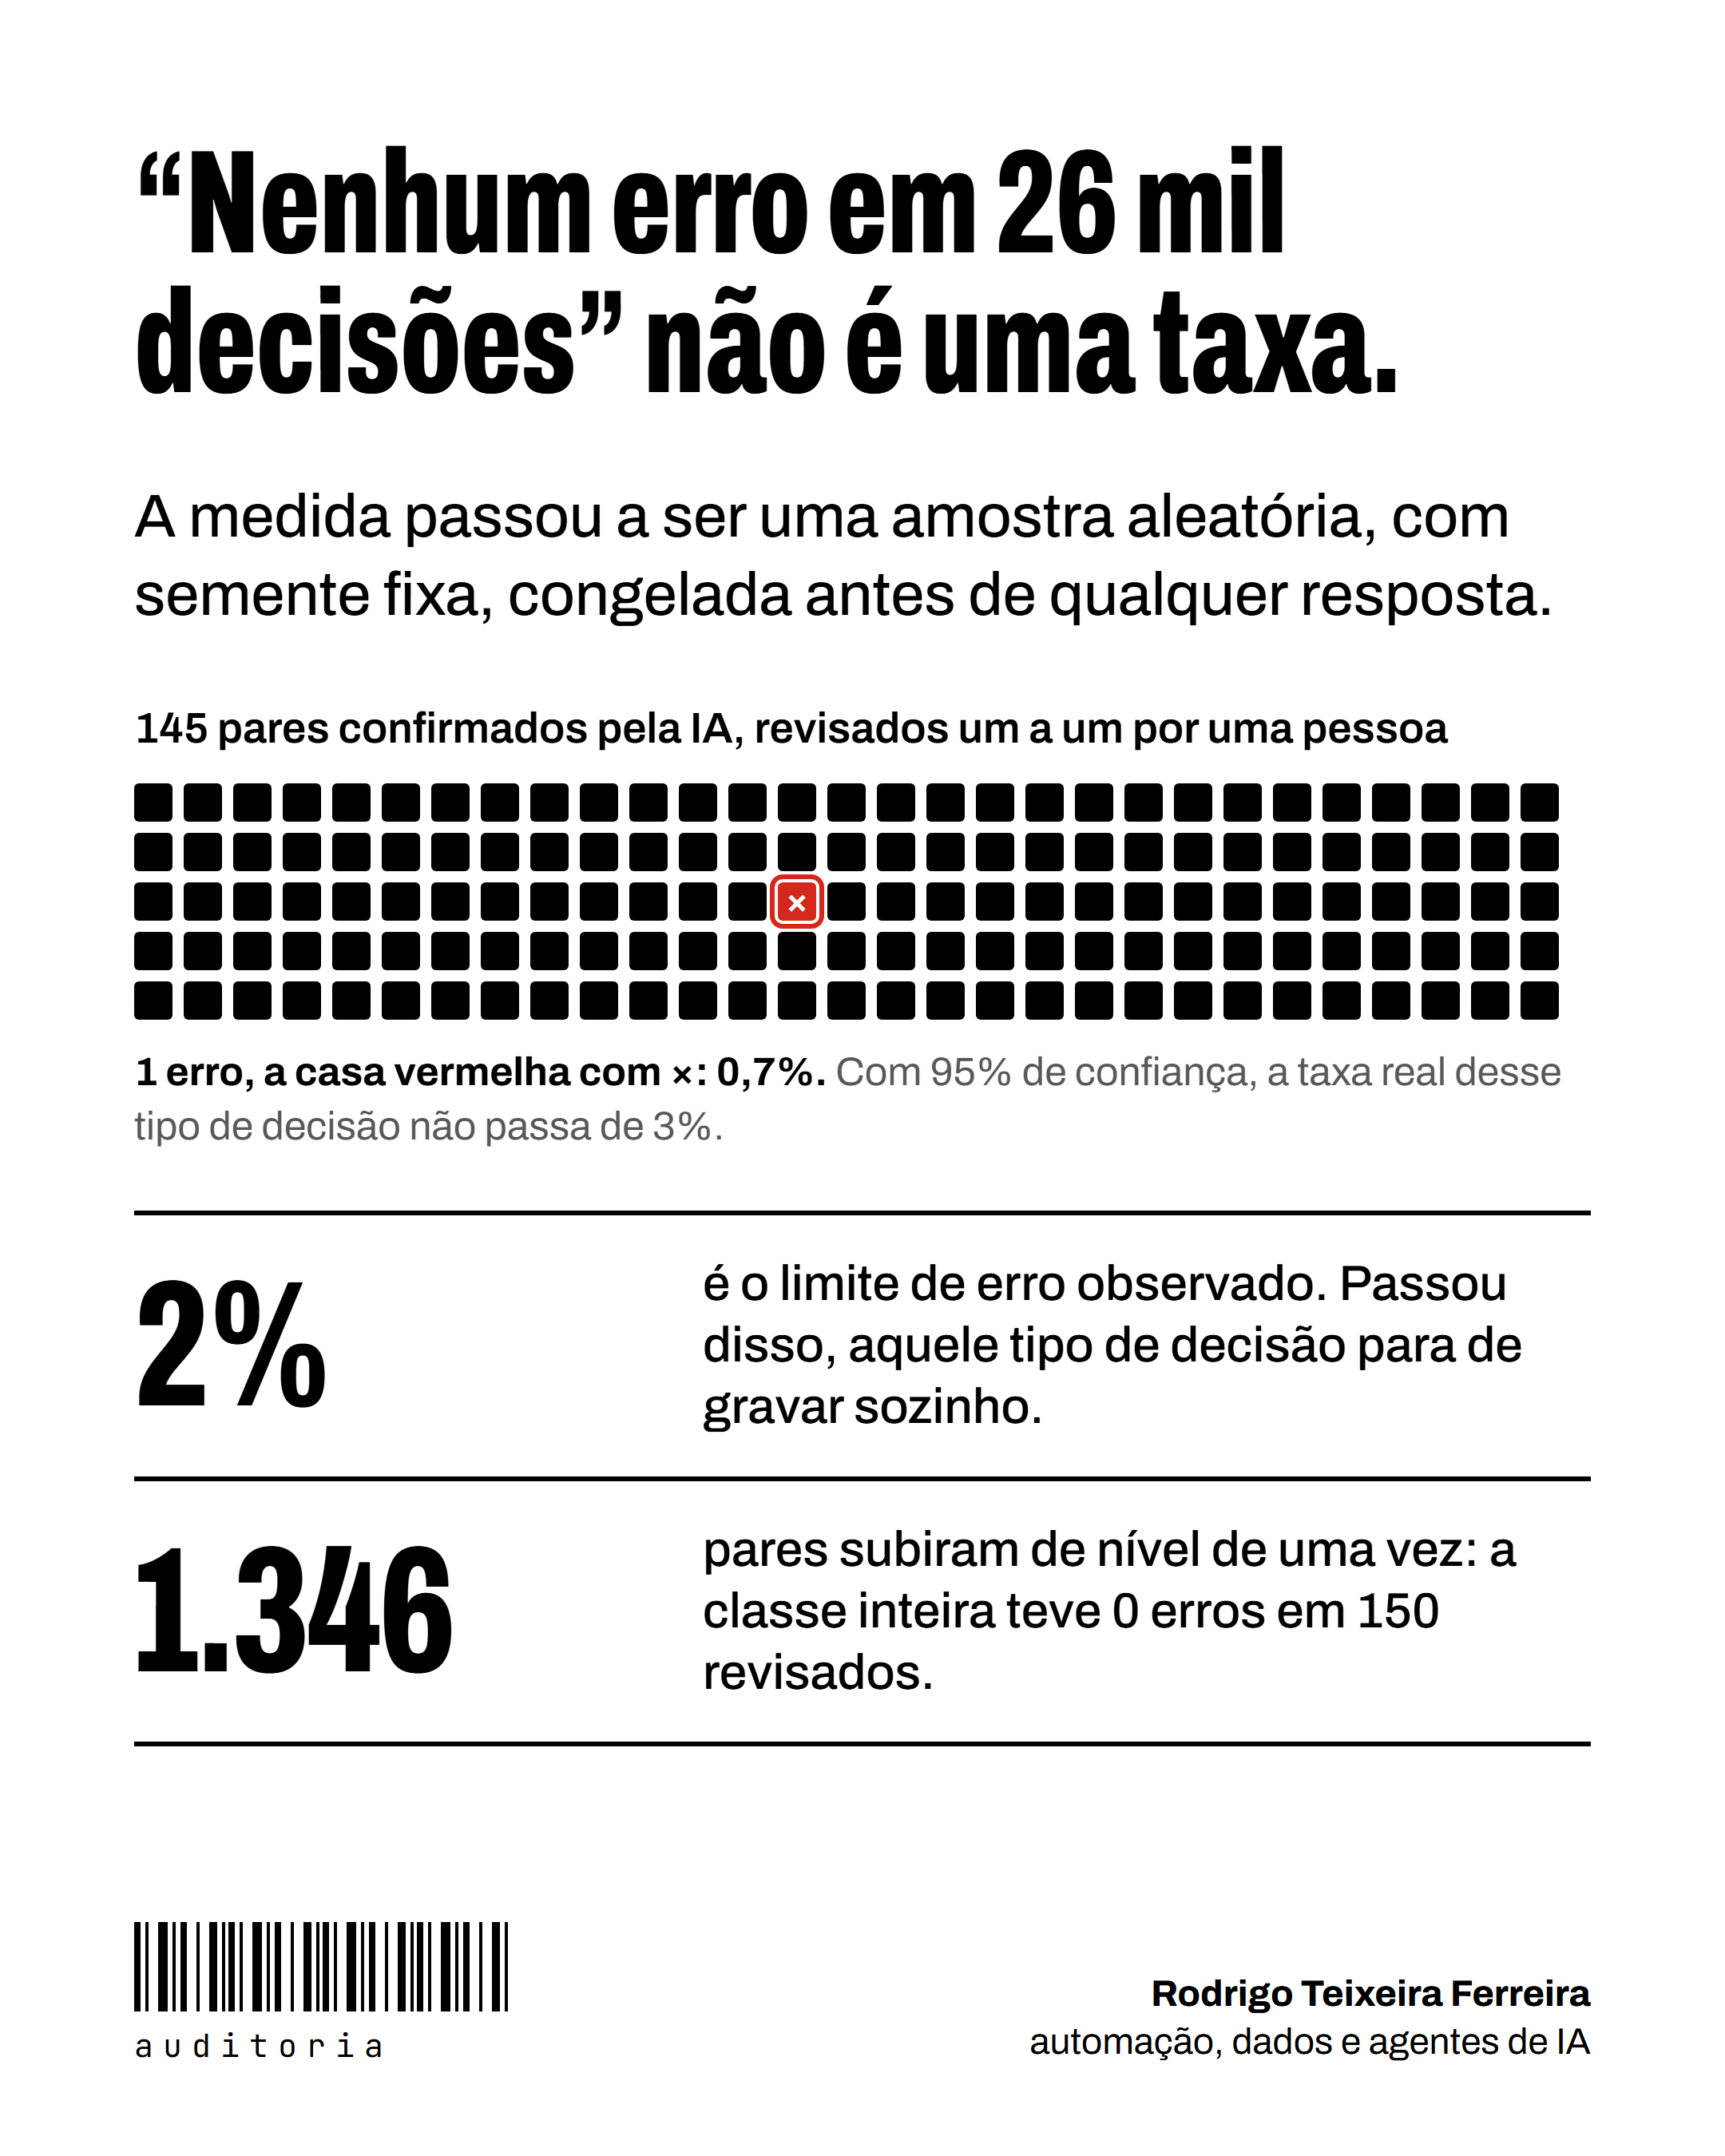
Durante um tempo eu tinha um número bonito: nenhum erro em 26 mil decisões. Ele não valia nada. Sem ninguém conferir, «nenhum erro» não é uma taxa. É só o que ninguém olhou.
Este texto é o método que pôs um número de verdade no lugar, e a regra que saiu dele. O código de uma versão pública, com dados fictícios, está no repositório linkado no fim.
1. As regras vêm antes do sorteio
Antes da primeira resposta, as regras da passada ficaram escritas: o que conta como erro em cada tipo de decisão e o que acontece com o tipo que passa (sobe de nível). E não mudaram durante a revisão.
Se a regra muda depois de ver o resultado, a medida vira opinião.
2. Uma amostra por tipo de decisão, congelada
A taxa geral esconde o que importa. Uma recusa errada esconde um par certo; um par confirmado errado vira preço errado na tela do comprador. Por isso a amostra foi estratificada por tipo de decisão: 463 decisões de cinco tipos (o par confirmado, o par de um sabor que a lista não separa, o par de tamanho desatualizado no cadastro, a recusa por motivo e a associação automática de nível 4).
Dois cuidados:
- semente fixa: o sorteio pode ser refeito e conferido por qualquer um;
- congelada antes da primeira resposta: a amostra é gravada antes de alguém responder, e quem responde não vê o que a máquina decidiu ganhar.
Na versão pública, isso são duas tabelas. A rodada guarda a semente, o tamanho da amostra por regra e o limite de erro; cada item guarda o par sorteado e, depois, a resposta (right ou wrong), quem respondeu e quando.
3. Uma pessoa responde tudo, numa tela feita para isso
As 463 decisões foram revisadas por uma pessoa, numa tela própria, pelo teclado, com espaço para comentário. Levou menos de seis horas. Uma tarde de revisão humana é o preço de saber quanto a IA erra.
4. O resultado, e o que quer dizer «até 3%»
- 1 erro em 145 nos pares confirmados (0,7%);
- nenhum nos outros tipos.
0,7% é o que a amostra viu. A pergunta honesta é outra: qual é o maior erro real que ainda combina com o que a amostra viu? Esse é o limite superior. Com 95% de confiança, o erro real do par confirmado não passava de 3%.
A intuição, sem fórmula: se o erro real fosse muito alto, seria muito improvável sortear 145 pares e achar só um errado. O limite superior é o ponto a partir do qual ver «1 em 145» passa a ser improvável demais (menos de 5% de chance).
O tamanho da amostra pesa muito. Na auditoria da demo pública (semente 1), com o mesmo método:
| Tipo de decisão | Amostra | Erros | Erro real, com 95% de confiança |
|---|---|---|---|
| código de barras | 50 | 0 | até 5,8% |
| atributos idênticos | 40 | 0 | até 7,2% |
| identidade com preço em dúvida (em teste) | 1 | 0 | até 95% |
Zero erros em 1 item não prova nada: o erro real pode ser quase qualquer coisa. Por isso, na demo, uma regra em teste só é ligada com pelo menos 20 itens na amostra.
A conta da demo é o limite de Clopper-Pearson unilateral, feito por busca binária, sem biblioteca de estatística:
from math import comb

def upper_bound(errors: int, n: int, confidence: float = 0.95) -> float:
    """O maior erro real compatível com o que a amostra viu: P(X <= errors | n, p) = 1 - confiança."""
    if n == 0 or errors >= n:
        return 1.0
    alpha = 1 - confidence
    lo, hi = errors / n, 1.0
    for _ in range(60):
        mid = (lo + hi) / 2
        cdf = sum(comb(n, k) * mid ** k * (1 - mid) ** (n - k) for k in range(errors + 1))
        lo, hi = (mid, hi) if cdf > alpha else (lo, mid)
    return hi
5. A regra dos 2%
A decisão do mesmo dia: um tipo de decisão para de gravar sozinho quando a taxa observada passa de 2%. É a taxa observada, isto é, erro de verdade, que desliga. O limite largo de uma amostra pequena não desliga nada; ele fica registrado para quem decide ver a incerteza.
Dois efeitos que eu não esperava:
- A amostra promoveu. A associação automática de nível 4 teve 150 revisados e nenhum erro. A regra combinada antes do sorteio mandava promover: 1.346 pares subiram para confirmados, com o motivo escrito no banco («confirmado por amostra: 0 erros em 150»).
- A amostra desligou coisa minha. Uma passada escrita em Python, sem IA, errou 2 de 7 e perdeu o direito de gravar sozinha.
A regra não é sobre a IA. É sobre qualquer coisa que decide sem uma pessoa olhar.
6. O único erro virou regra, com teste
O erro foi uma apresentação de presente (a caixa) que a regra tratava como embalagem comum, das que o cadastro não escreve. Virou regra nova, com teste. Os comentários do revisor nos acertos também viraram propostas de vocabulário, de leitura e de preço. A amostra mede e, de quebra, ensina.
7. A mesma regra rodando sozinha na demo
Na demo pública, a regra «semelhança alta» entra em teste, é auditada e erra 18 de 18 na amostra. É desligada sem ninguém mexer, e a cascata roda de novo nas listas que valem.
O limite honesto: na demo, o auditor é simulado (responde pelo gabarito do mundo gerado). No sistema original, quem respondeu foi uma pessoa.
8. Como replicar no seu projeto
- Liste os tipos de decisão automática. Cada um ganha a sua taxa.
- Escreva antes: o que é erro, o limite que desliga (2% foi o meu), o mínimo de amostra para ligar.
- Sorteie com semente fixa e grave a amostra antes da primeira resposta.
- Faça a revisão ser rápida: uma tela, um par por vez, teclado.
- Guarde taxa observada e limite superior de cada rodada, com a decisão tomada.
- Rode de novo a cada mudança de regra ou de modelo.
O mesmo raciocínio vale para leitura de documento: no comparador, a foto de uma lista é lida duas vezes, em contextos separados, e só segue o que as duas leituras dizem igual. Contra o gabarito de seis listas, 157 de 166 linhas saíram iguais e certas, nenhuma com preço errado; as 9 restantes eram as que uma das leituras marcou com dúvida.
Medir a IA custou uma tarde. Não medir custaria a confiança no sistema inteiro.
O código da auditoria (src/pricelists/audit.py), as tabelas (supabase/migrations/) e o texto curto do método (docs/02-medir-a-ia.md) estão no repositório da demo: https://github.com/rodrigoteixeiraferreira/comparador-listas-fornecedores
Como vocês medem o erro dos agentes e classificadores que já estão em produção?