Pitch: Criei o AI gateway mais rápido do mundo (e ele é open source)
Se você já colocou LLM em produção, provavelmente conhece essa história. Começa com uma chave da OpenAI no .env e uma chamada direto pra API. Funciona, todo mundo fica feliz.
Aí alguém pede pra testar o Claude. Depois a OpenAI cai numa sexta à tarde e você descobre que não tinha fallback. O financeiro quer saber quanto cada time está gastando. E um belo dia alguém do jurídico pergunta se tem CPF de cliente indo dentro do prompt.
A resposta pra tudo isso costuma ser a mesma: colocar um AI gateway no meio do caminho, entre as suas aplicações e os provedores. Eu testei os que existem e sempre esbarrava nas mesmas coisas: overhead alto quando a carga sobe, um consumo de memória que não faz sentido pra um proxy, e uma pilha de serviços pra subir só pra ter um painel.
Então eu fiz o meu. Ele se chama Antirion, é escrito em Rust, open source (Apache-2.0), e acabei de lançar a versão 0.1.1. Quero mostrar como ele funciona, por que ficou tão rápido, e ouvir de vocês o que está faltando.
Mas o que exatamente um AI gateway faz?
Pensa num proxy que entende de LLM. Suas aplicações continuam falando a API da OpenAI (ou da Anthropic, do Gemini, do Bedrock), só que apontando pro gateway. Ele decide pra qual provedor mandar, traduz o formato se precisar e devolve a resposta como se nada tivesse acontecido.
Na prática, um código escrito com o SDK da OpenAI pode chamar o Claude sem mudar uma linha, inclusive com streaming, que é traduzido evento por evento.
No meio do caminho, o Antirion cuida de:
- Fallback e roteamento: se um provedor cai, ele tenta o próximo. Dá pra rotear por custo, por latência ou por peso, com retries e circuit breakers.
- Gasto: rate limits e orçamentos em dólar ou em tokens por time, projeto e chave, com alerta antes de estourar.
- Dados sensíveis: guardrails que pegam PII, segredos e prompt injection, e mascaram o dado mantendo o formato.
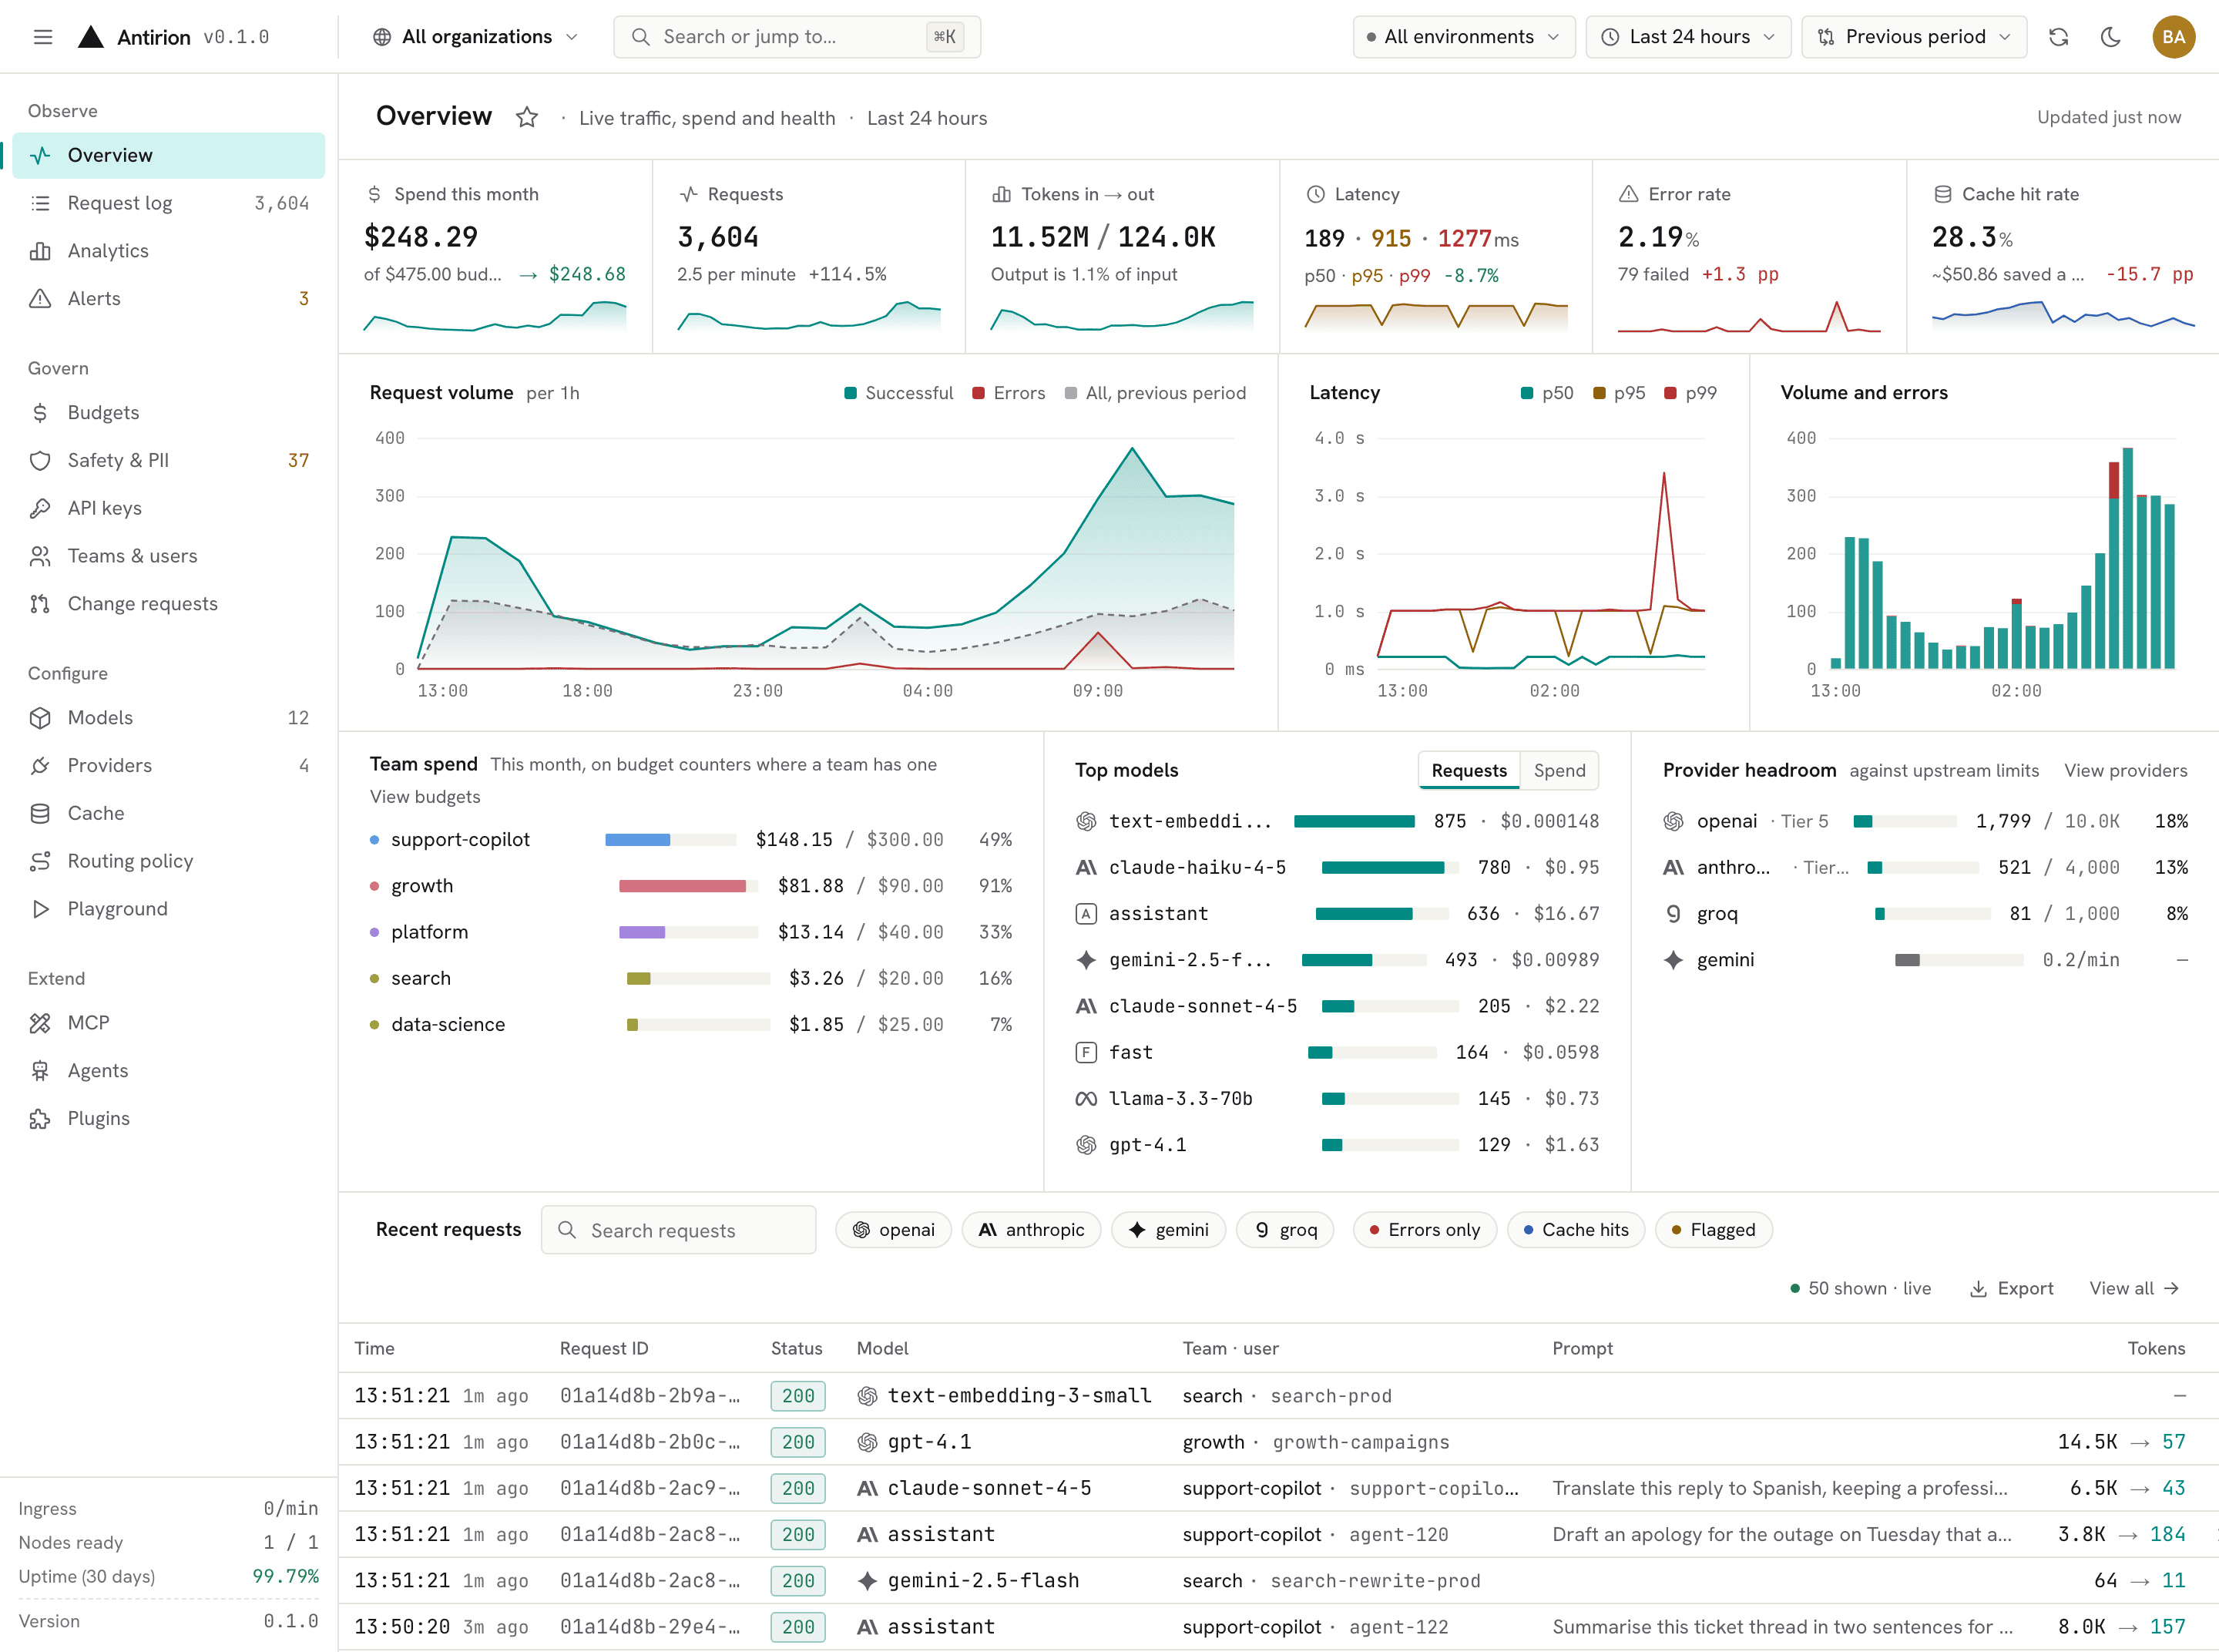
- Visibilidade: cada requisição fica registrada com a rota, as tentativas, os tokens e o custo.
- MCP e A2A: servidores MCP (remotos, locais ou gerados a partir de um OpenAPI) e agentes A2A ficam atrás das mesmas chaves e limites.
E tudo isso vem num binário só. A API de administração e o console web estão dentro dele, sem sidecar e sem deploy separado de frontend. Ele conversa com OpenAI, Azure, Anthropic, Bedrock, Vertex AI, Gemini, Mistral, Groq, DeepSeek, xAI e qualquer servidor compatível, como o vLLM.
Como uma requisição passa por ele
O binário tem dois lados. A porta 8080 é o data plane, que atende seus apps. A 8081 é o admin plane, com o console e a Admin API. Tudo que o console faz passa por essa API, então dá pra automatizar qualquer coisa que você faria clicando.
Cada requisição é autenticada, passa pelos limites e pelos guardrails, tenta o cache e só então vai pro provedor. Quando ela termina, o registro completo é gravado. Rodando sozinho, o armazenamento é embutido; em cluster, os nós compartilham PostgreSQL e Valkey.
Testando em 2 minutos
Você só precisa de Docker e de uma chave da OpenAI ou da Anthropic. Não tem arquivo de configuração pra escrever:
docker run -p 8080:8080 -p 8081:8081 \
  -v antirion-data:/var/lib/antirion eliasbiondo/antirion
Na primeira vez ele imprime o endereço do console e um token de admin. Daí é:
- Abrir
http://localhost:8081/ui/e entrar com o token. - Em Providers, adicionar a OpenAI ou a Anthropic. Ele testa a chave antes de salvar, então se você colou errado, descobre ali mesmo.
- Em Models, criar um Model chamado
chatapontando pra, por exemplo,gpt-4.1-mini. - Em API keys, criar uma chave e mandar a primeira requisição:
curl -s http://localhost:8080/v1/chat/completions \
  -H "Authorization: Bearer $ANTIRION_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{"model": "chat", "messages": [{"role": "user", "content": "Olá"}]}'
Se você já usa o SDK da OpenAI, basta trocar o base_url pra http://localhost:8080/v1. A requisição aparece no Request log com rota, tokens, latência e custo.
Pra produção tem Docker Compose, modo cluster e Helm chart.
Tá, mas por que ele é tão rápido?
Um gateway fica no caminho de toda chamada. Se ele adiciona 20 ms, são 20 ms a mais em cada requisição da sua empresa, pra sempre. Então desempenho foi requisito desde o primeiro commit, e algumas decisões fizeram mais diferença que outras:
- Uma thread por CPU, e a requisição não sai dela. Cada thread tem seu próprio runtime e, no Linux, seu próprio socket num grupo
SO_REUSEPORT. A conexão do cliente, as tarefas dela e a conexão com o provedor ficam todas na mesma thread, e nenhuma outra precisa acordar. - O corpo da requisição quase nunca é copiado. Escrevi um parser JSON que valida o corpo e guarda onde começa e termina cada campo. Quando o gateway precisa trocar o
model, ele manda fatias dos bytes originais em volta do campo alterado, em vez de desmontar e remontar o JSON. - Rust, sem garbage collector, com jemalloc no Linux.
- Uma arquitetura que o build não deixa bagunçar. São 28 crates em 8 camadas, e um crate só pode depender das camadas abaixo dele. Se alguém furar a regra, o CI quebra.
- A configuração é um documento só, validado por JSON Schema e versionado. Dá pra ver o diff, voltar uma versão, e a mudança vale pra todos os nós sem restart.
Os números
Falar que é rápido é fácil, então eu medi.
Rodei o Antirion, o Bifrost 2.2.4 e o LiteLLM 1.103.1 na mesma máquina da AWS (uma c7i.xlarge, com 4 vCPUs), intercalando as rodadas, todos com a mesma configuração mínima. O gerador de carga e o servidor que responde ficam em máquinas separadas, e a carga é open loop: se o gateway engasga, a fila aparece na latência.
Esse é o resultado de um chat simples a 5.000 requisições por segundo (mediana das rodadas):
| Antirion | Bifrost 2.2.4 | LiteLLM 1.103.1 | |
|---|---|---|---|
| Overhead p50 | 0,53 ms | 19,7 ms | — |
| Overhead p99 | 0,95 ms | 95,2 ms | — |
| Erros | 0% | 0% | 100% |
| CPU por requisição | 247 µs | 717 µs | — |
| Memória no pico | 215 MiB | 1.389 MiB | 1.851 MiB |
| Memória ociosa | 41 MiB | 498 MiB | 1.653 MiB |
Na mesma máquina, o Antirion aguentou 14.000 requisições por segundo antes de saturar. O Bifrost parou em 3.500, e o LiteLLM não passou de 500.
Mas não precisa acreditar em mim. O método completo e o passo a passo pra rodar o mesmo benchmark na sua conta da AWS estão em docs/benchmarks.md, e o código está em bench/. Se achar algum erro na metodologia, me avisa que eu corrijo.
E agora?
O projeto está na 0.1.1 e ainda tem muita coisa pra lapidar. Se você roda LLM em produção, eu adoraria saber:
- Qual gateway você usa hoje, e o que mais te incomoda nele?
- Que provedor ou recurso faltou pra você testar o Antirion?
O código está em github.com/eliasbiondo/antirion e a imagem Docker é eliasbiondo/antirion. Se achar útil, uma estrela lá ajuda o projeto a ser encontrado. E pode mandar a pergunta que for aqui nos comentários, que eu respondo todas.