Pitch: O que aprendi tentando monitorar itens (não páginas) com LLM e scraping
Oi, pessoal. Sou o Bruno e passei os últimos meses construindo o BriefPanel sozinho. Pelos termos daqui, pitch é bem-vindo quando devolve conhecimento técnico, então vou contar o que ele faz e, principalmente, o que deu trabalho para fazer funcionar.
O problema
Ferramentas de monitorar páginas existem há anos (Visualping, Distill etc.). Quase todas fazem a mesma coisa: baixam a página, comparam com a versão anterior e te mandam um diff.
Isso funciona para uma página de termos de uso. Não funciona para uma página de listagem: preços de concorrentes, vagas, imóveis, produtos de um marketplace, changelog. Nesses casos o diff vira ruído: a ordem muda, um banner troca, um card de "você também pode gostar" aparece, e você recebe um alerta que não diz nada.
O que eu queria saber era outra coisa: qual item mudou, o que mudou nele, e qual o histórico daquele item ao longo do tempo.
O que o BriefPanel faz
- Você cola uma URL. Ela vira uma fonte.
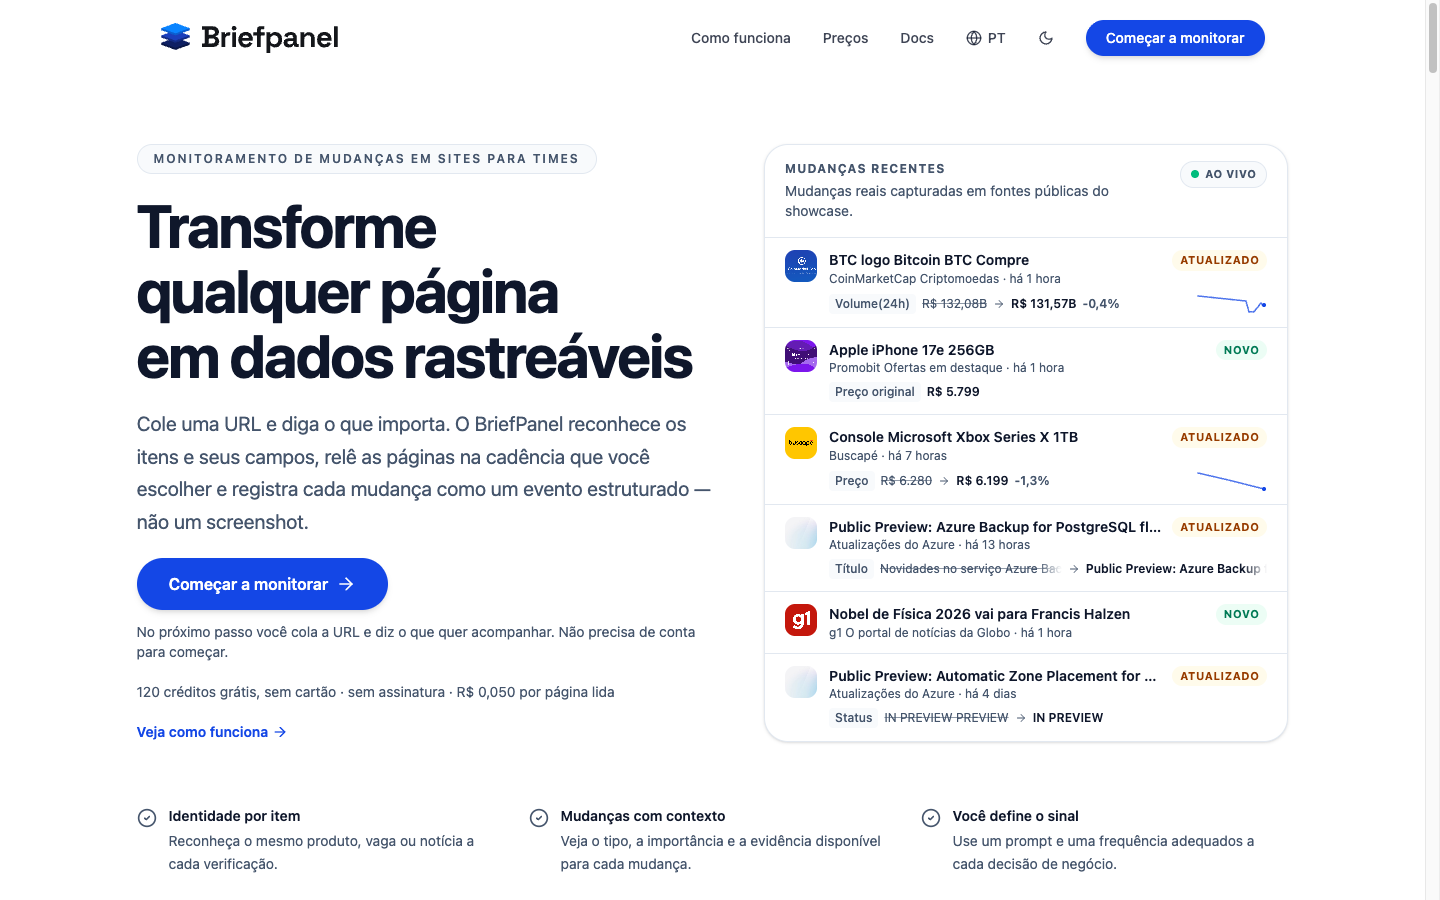
- O BriefPanel lê a página e extrai os itens que importam (produtos, vagas, anúncios, notícias...). Cada item ganha uma identidade estável.
- A cada verificação, ele diz o que é novo, o que foi modificado (ex.: preço de R$ 120 para R$ 99) e o que foi removido.
- Quando o item tem página própria, ele pode abrir essa página para ler os detalhes.
- Você pode escrever em linguagem natural o que importa ("só me avise de queda de preço" ou "só vagas remotas").
- Notificação por e-mail, push ou resumo diário/semanal.
A stack
- Backend: Convex (funções, workflows e banco). Ter o banco reativo e as filas no mesmo lugar simplificou muito a vida de quem está sozinho.
- Web: Next.js. App: Expo (React Native, que também roda na web).
- Serviço de ML em Python (FastAPI): embeddings e um ranker que decide quais blocos da página são conteúdo e quais são "cromo" (menu, rodapé, carrossel de recomendação).
- LLMs via OpenRouter, para poder trocar de modelo e provedor sem reescrever nada.
- Crawling: provedores de scraping com fallback, porque nenhum deles abre todos os sites.
O que deu trabalho (a parte que talvez sirva para você)
1. Identidade de item é o problema central, não o diff.
Para dizer "o preço deste produto mudou" você precisa saber que é o mesmo produto da última vez. URL parece a chave óbvia, mas muitos sites colocam id de sessão ou parâmetros de rastreio no caminho. Resultado: o mesmo produto aparece como item "novo" a cada visita. Tive que normalizar URLs por padrão de site e combinar URL com nome e outros sinais.
2. Página de bloqueio chega como sucesso.
Vários sites respondem 200 com uma página de "confirme que você é humano". Se você não detectar isso, o sistema conclui que todos os itens foram removidos. Hoje, uma leitura que "some com tudo" é tratada como suspeita antes de virar alerta.
3. O mesmo site devolve HTML diferente para cada provedor.
Mudar de provedor de scraping (ou de país do proxy) pode mudar a página inteira. Isso gera falsos "removidos" e "novos". A comparação precisa saber de onde veio cada leitura.
4. LLM erra magnitude de preço.
Um modelo leu "R$ 80 milhões" como 80.000. Agora toda leitura de preço é conferida contra o texto visível da página: se o valor só existe lá em outra potência de 10, a leitura é recusada.
5. Carrossel de "anúncios parecidos" contamina o item.
Na página de um imóvel, o modelo às vezes copiava o preço de um card da seção de recomendados. A regra que resolveu: um campo só muda se o valor antigo saiu da página. Se o valor antigo continua lá, provavelmente o novo veio de outro lugar.
6. Sem avaliação offline, você não sabe se melhorou ou piorou.
Montei um corpus de páginas reais com o resultado esperado e gravo as respostas dos modelos em cassetes (estilo VCR). Assim consigo rodar a avaliação de novo sem pagar outra vez, e comparar prompts e modelos com números em vez de impressão.
Para quem é
Pensei em uso profissional: acompanhar preços e catálogo de concorrentes, vagas, imóveis, normas e avisos públicos, changelogs e documentação de APIs que você integra. Se você é dev, o último caso é o mais direto: saber quando uma API que você usa mudou algo, sem ler o changelog inteiro toda semana.
O modelo de cobrança é por créditos, sem assinatura. Ao criar a conta você ganha créditos para testar.
Quero ouvir vocês
- Que página vocês monitorariam?
- Se alguém já resolveu identidade de item em scraping de um jeito melhor, quero muito saber.
- Críticas são bem-vindas, principalmente onde o produto não acertou.
Link: https://briefpanel.com