Medi 7 modelos de IA lendo cardápio. O mais barato custou 1/15 e errou menos
Fala, pessoal. Eu trabalho com produto de delivery e tinha uma dúvida chata: o lojista manda a foto do cardápio, a IA monta o cadastro, e aí qual modelo usar? Todo mundo escolhe no palpite, então eu resolvi medir.
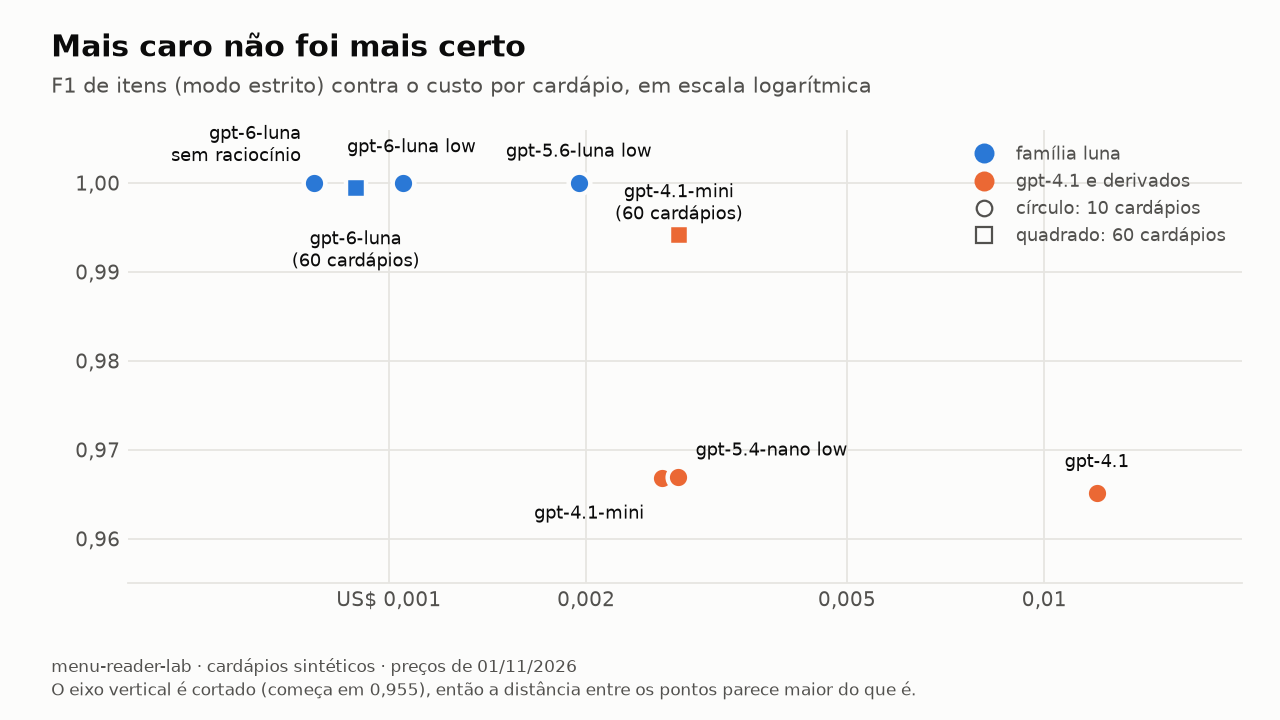
Spoiler: o mais caro não foi o mais certo.
Como eu medi
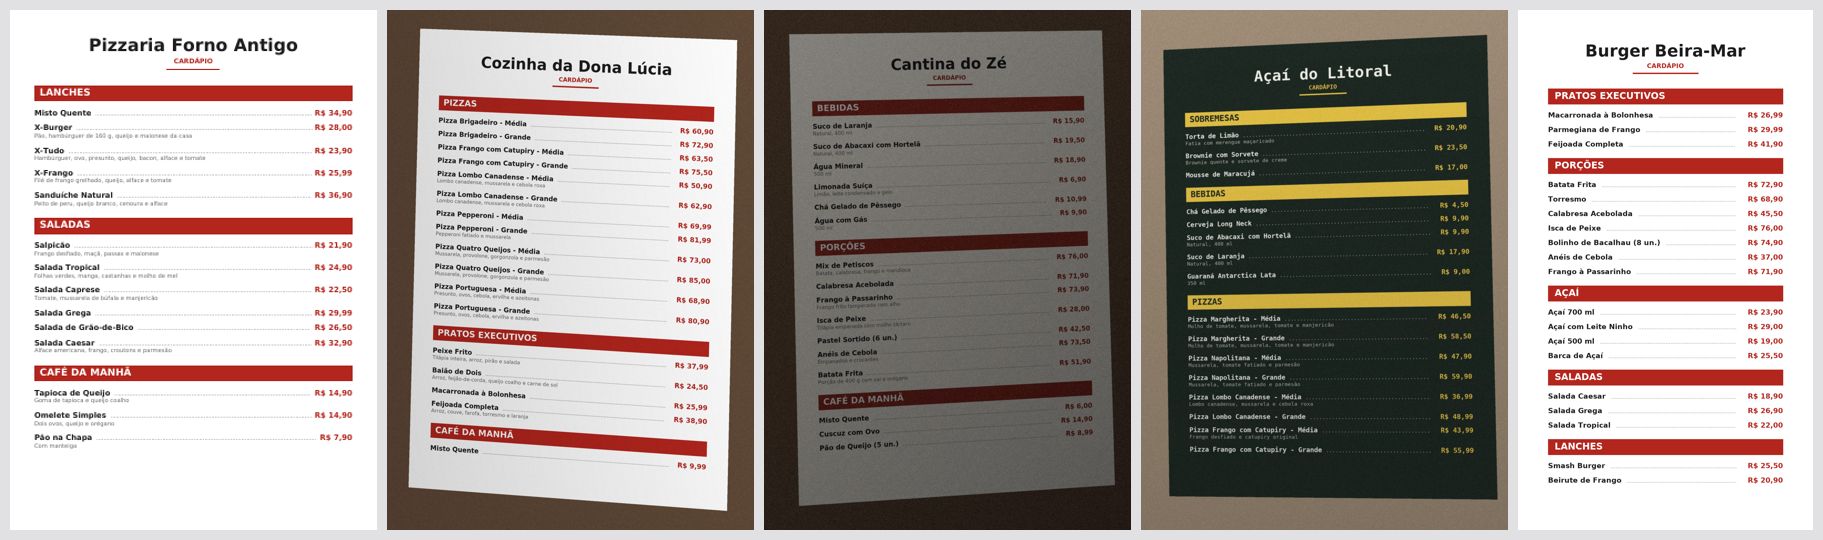
Gerei 60 cardápios sintéticos (1.561 itens, 10 estilos, de PDF limpo a foto torta com pouca luz). Sintético porque assim eu sei exatamente o que tem em cada um, e não preciso usar cardápio de lojista nenhum.
O avaliador casa cada item pelo nome e depois confere preço e categoria. Antes de confiar nele, testei com leitores falsos de erro conhecido:
| Leitor | F1 de itens | Revocação | Inventado |
|---|---|---|---|
| oráculo (devolve o gabarito) | 1,0000 | 1,0000 | 0,0000 |
| erra 10% de propósito | 0,8787 | 0,8584 | 0,1001 |
| erra 30% de propósito | 0,6557 | 0,5894 | 0,2610 |
Todo gasto com API tem teto (--max-usd), checado antes de cada chamada. As duas rodadas custaram US$ 0,43 no total.
O resultado
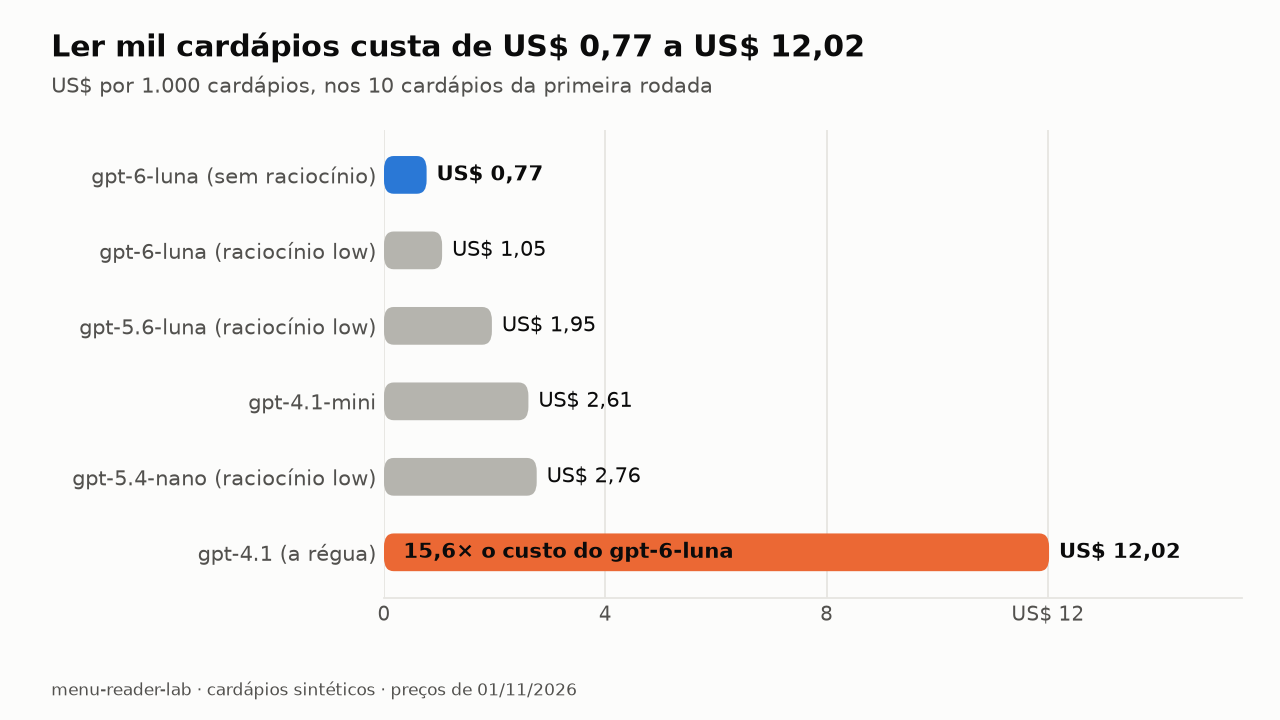
Primeira rodada: 7 modelos da OpenAI em 10 cardápios (243 itens), um de cada estilo.
| Modelo | F1 estrito | F1 tolerante | US$ por 1.000 cardápios | Mediana |
|---|---|---|---|---|
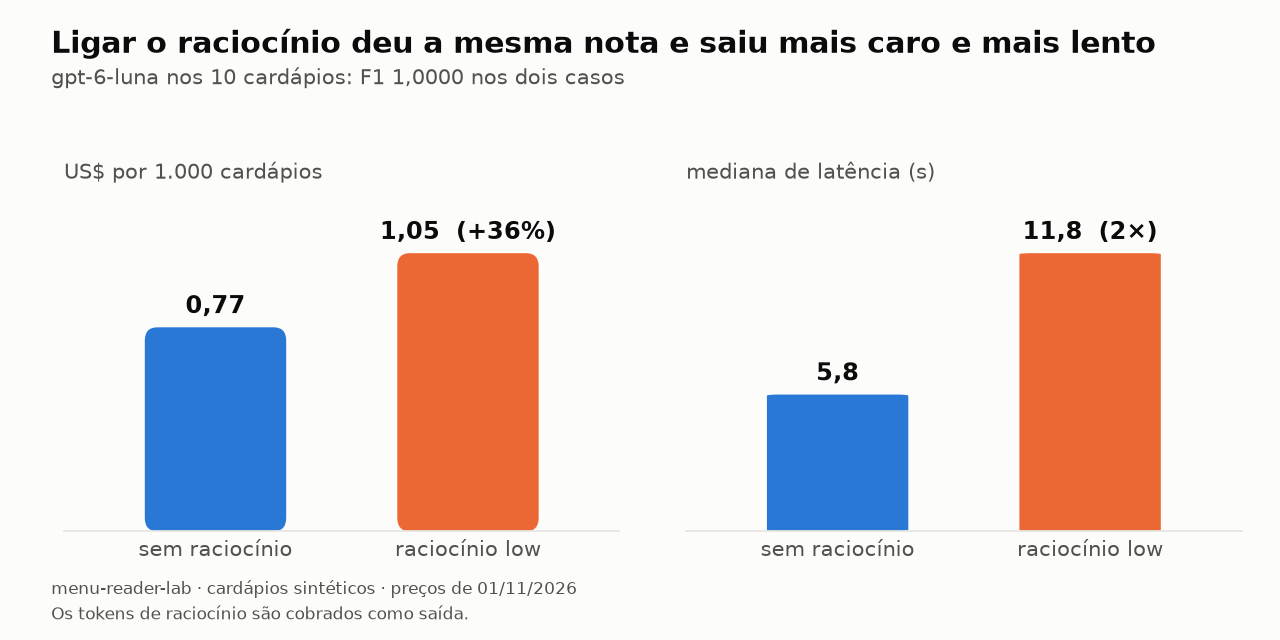
gpt-6-luna, sem raciocínio | 1,0000 | 1,0000 | 0,77 | 5,8 s |
gpt-6-luna, raciocínio low | 1,0000 | 1,0000 | 1,05 | 11,8 s |
gpt-5.6-luna, raciocínio low | 1,0000 | 1,0000 | 1,95 | 7,7 s |
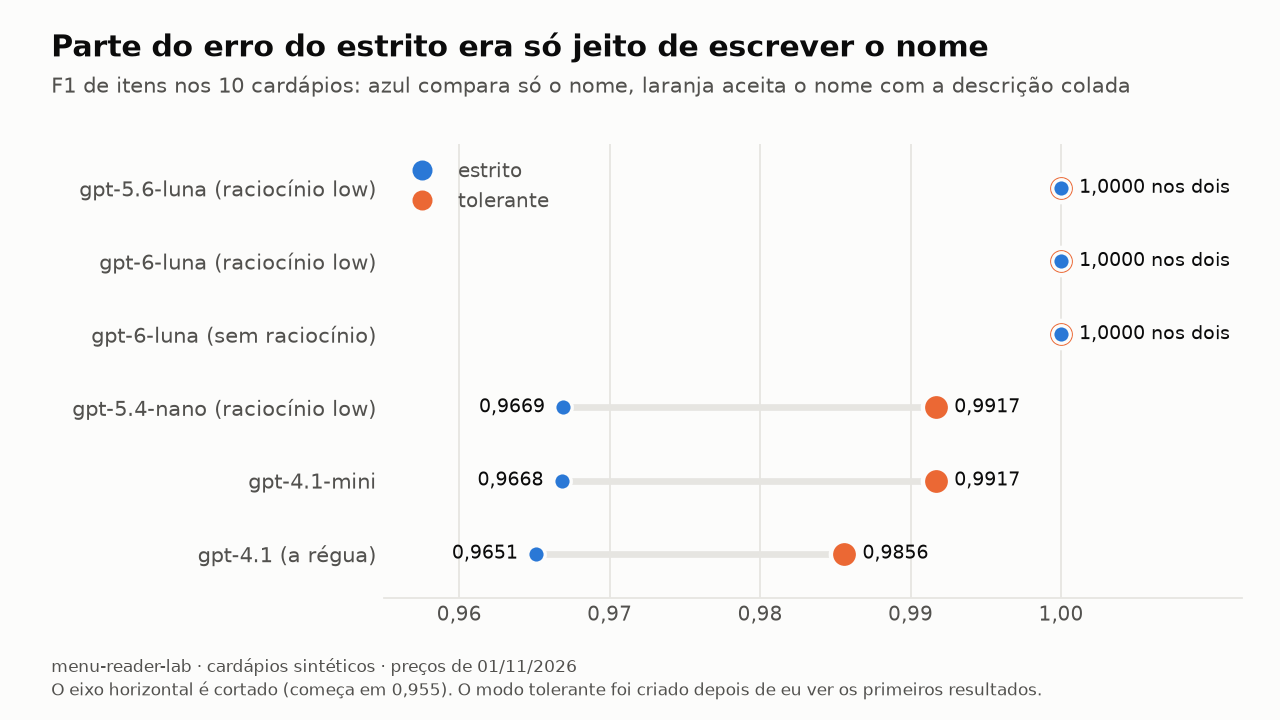
gpt-4.1-mini | 0,9668 | 0,9917 | 2,61 | 7,2 s |
gpt-5.4-nano, raciocínio low | 0,9669 | 0,9917 | 2,76 | 10,6 s |
gpt-4.1 (a régua) | 0,9651 | 0,9856 | 12,02 | 6,5 s |
O gpt-4.1-nano nem entrou: a página de preços ainda lista, mas a API respondeu 404 (descontinuado).
Onde o dinheiro vai
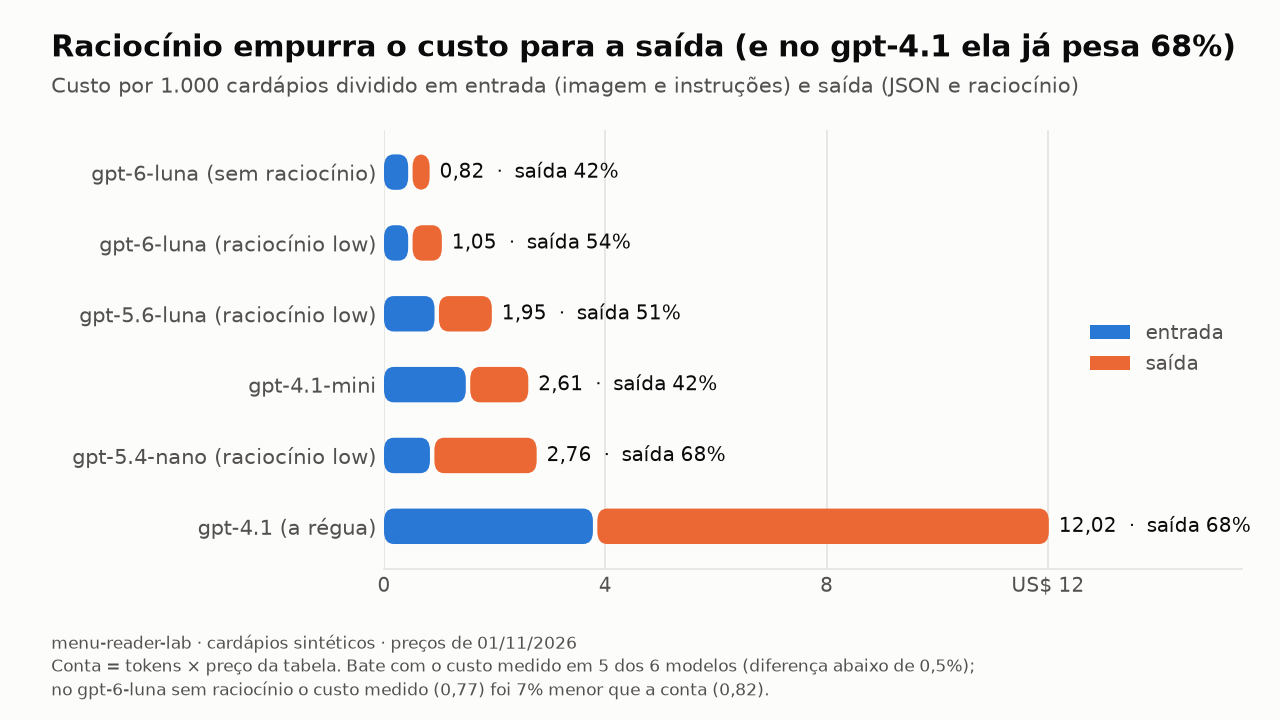
Sem raciocínio, mais da metade do custo é entrada (a imagem). Ligar o raciocínio empurra o gasto para a saída, e no gpt-4.1 a saída já pesa 68%. No gpt-6-luna, o raciocínio deu a mesma nota e só encareceu:
O avaliador me enganou
Na primeira rodada, vários modelos escreveram "Água Mineral 500 ml" onde o gabarito tem o nome "Água Mineral" e a descrição "500 ml". É a mesma informação, mas meu avaliador contava como um item inventado e um perdido ao mesmo tempo.
Criei então o modo tolerante, que aceita o nome com a descrição colada. Só que eu criei depois de ver os resultados, o que é meio suspeito, então as duas notas aparecem sempre lado a lado:
E nos 60 cardápios?
Os dois melhores leram o conjunto inteiro:
| Modelo | F1 estrito | F1 tolerante | Preço certo | Cardápios sem erro | US$ por 1.000 |
|---|---|---|---|---|---|
gpt-6-luna, sem raciocínio | 0,9994 | 0,9994 | 0,9987 | 55 de 60 | 0,89 |
gpt-4.1-mini | 0,9942 | 0,9968 | 0,9961 | 51 de 60 | 2,77 |
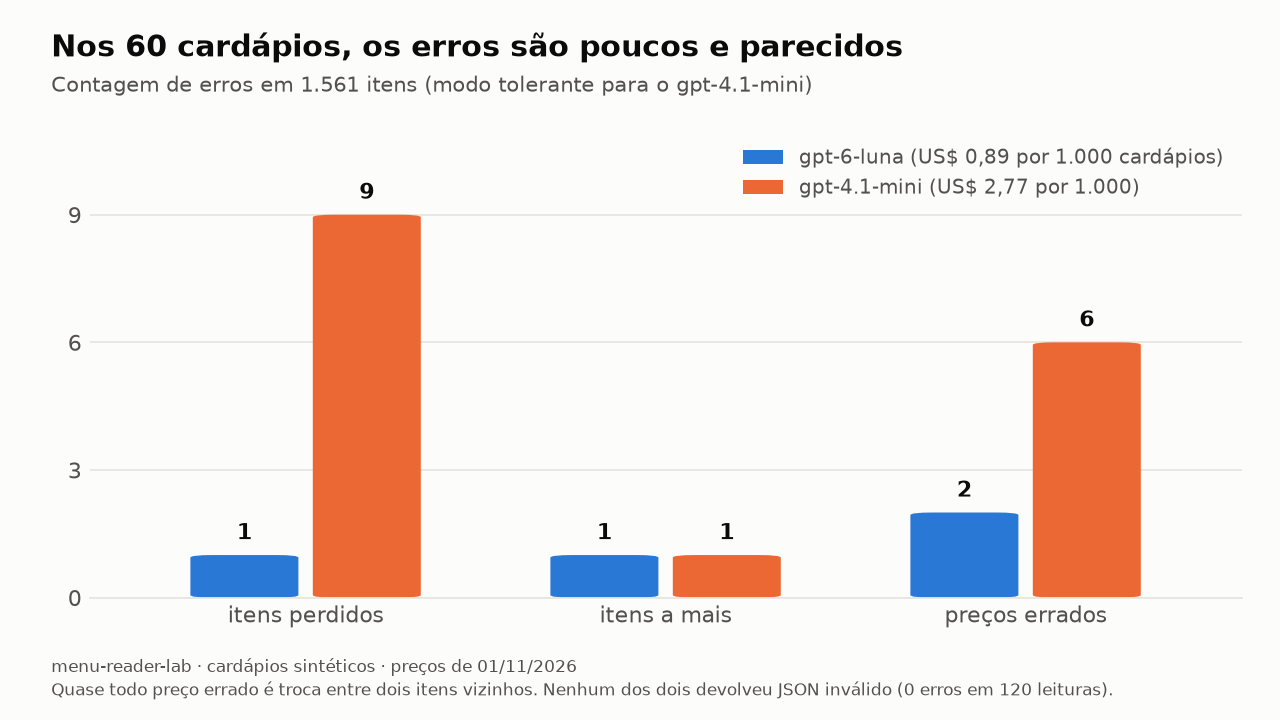
O gpt-6-luna acertou 1.560 dos 1.561 itens. Os erros dos dois são do mesmo tipo: preço trocado entre dois itens vizinhos num quadro-negro, coluna perdida num PDF de duas colunas. Ler os 60 cardápios com o gpt-6-luna custou US$ 0,053.
O que isso não prova
- Sintético é mais fácil que real. Fonte limpa, sem letra de mão, sem foto de cardápio dobrado. Os números são um teto.
- Só OpenAI. Anthropic, Gemini e modelos locais ficam para a próxima.
- Com 10 cardápios dá para ver o tipo de erro, mas não para ranquear modelos parecidos (a diferença é de 3 a 4 itens em 243). E zero erro em 243 itens é compatível com até uns 1,2% de erro real.
- Os preços são de 01/11/2026 e mudam.
O repositório
Está tudo aberto: o gerador recria os cardápios em uns 30 segundos com a mesma semente, e são 57 testes.
github.com/Juan-Severiano/menu-reader-lab
Se você achar algum furo no avaliador, me fala nos comentários.