Pitch: fiz 19 skills de LGPD pra agentes de código, e o mais difícil foi impedir que elas inventassem regra da ANPD
Fala, pessoal
Eu crio SaaS pequenos e sempre fui meio paranoico com dado pessoal.
O maior hoje é o Delfus, um bot de segurança pra comunidades no Discord. São 1,28 milhão de membros em 300+ servidores, e eu mantenho sozinho, código e fé.
Então desde maio eu mantenho o lgpd-skills: 19 skills open source (MIT) que fazem o agente de código olhar o repositório pelo lado da LGPD
Por que comecei
No Delfus eu já tinha montado na mão mapa de dados, base legal, política e runbook de incidente. Deu trabalho, e a parte chata era sempre a mesma: descobrir onde o dado pessoal estava de verdade.
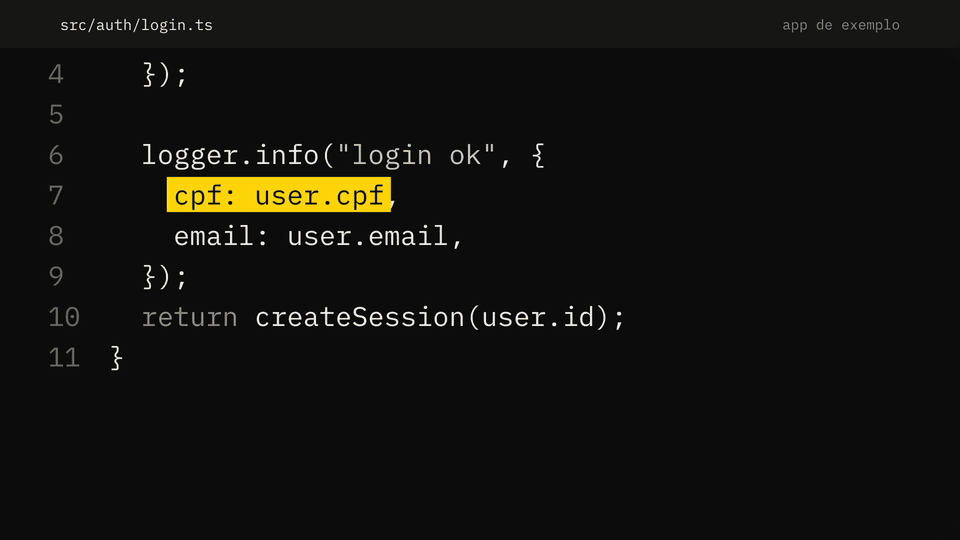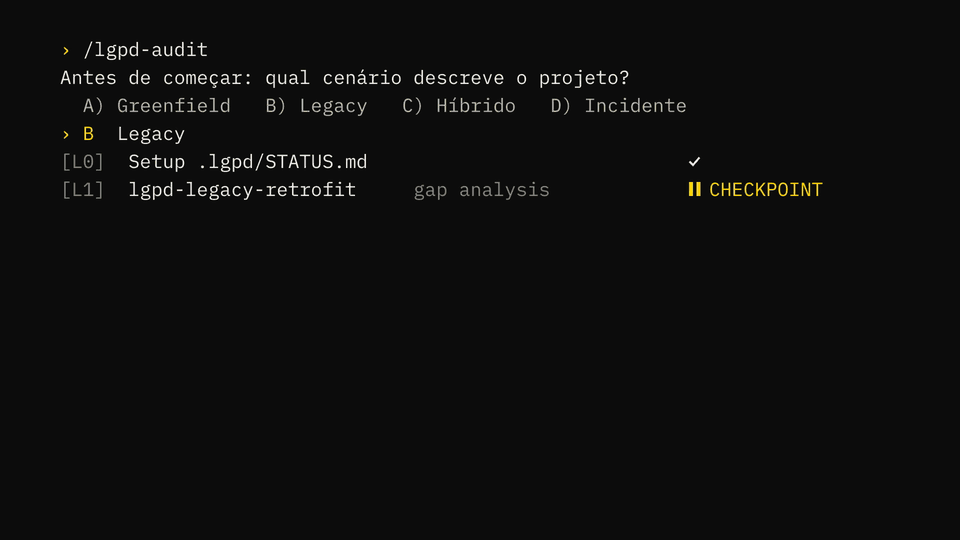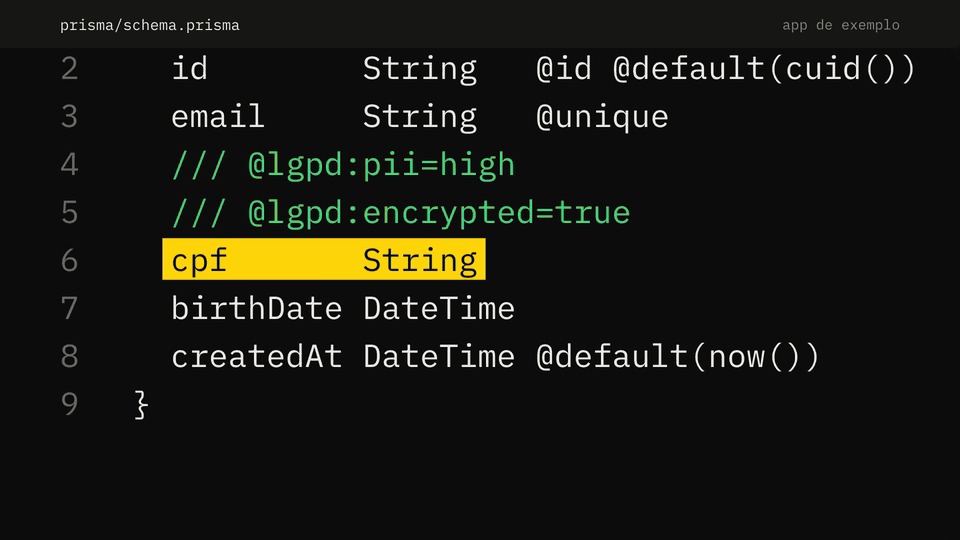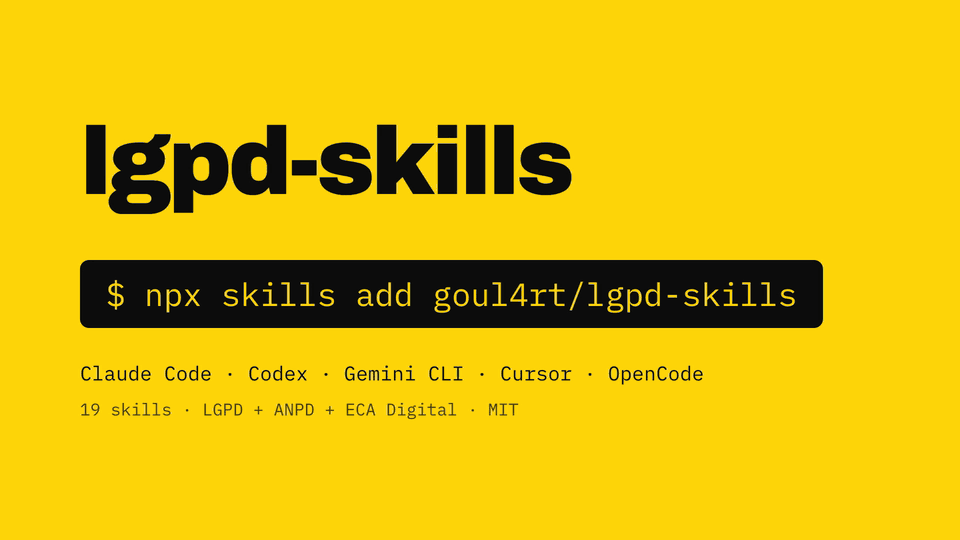
Porque a política costuma estar caprichada no rodapé. O problema mora em coisa assim:
logger.info("login ok", {
  dadoPessoal: user.dadoPessoal,
});
O CPF ou outra informação sensível vai pro log, o log vai pra uma ferramenta de observabilidade que guarda tudo por semanas, e bom, não lembrei de colocar essa ferramenta no mapa de dados.
Eu queria que o agente que já mexe no meu código pegasse isso sozinho.
Como funciona
Você roda /lgpd-audit e ele pergunta o cenário: projeto novo, legado em produção, um misto dos dois ou incidente acontecendo agora.
Cada um segue uma ordem. No incidente ele pula o inventário e vai direto pra contenção e registro, porque a Resolução CD/ANPD 15/2024 dá 3 dias úteis pra comunicar a ANPD.
No legado ele faz o inventário reverso (schema, rotas, SDKs de terceiros, cookies), monta os gaps por prioridade e vai passando pelas skills: base legal, Encarregado, fornecedores, criptografia de campo, direitos do titular, retenção. Se o produto tem usuário menor de idade, entra o ECA Digital também.
Tudo vai pra .lgpd/, dentro do repo: mapa de dados, ROPA, RIPD, rascunho de política. Entra no git, aparece no diff do PR, e alguém revisa igual revisa código.
E a parte que eu mais gosto: ele para. Antes de fechar ROPA, RIPD, política ou comunicação à ANPD, a execução pausa e espera uma pessoa. Base legal e teste de legítimo interesse são decisão de gente, e eu deixei isso travado.
Onde eu mais errei: o modelo inventando norma
Da primeira versão, em maio, uma das skills tratava "mais de 2 milhões de titulares" como limite automático de alto risco.
Parecia certinho. O número veio de uma minuta de guia orientativo que o Conselho Diretor da ANPD arquivou (Voto nº 11/2025), e ficou uns 5 meses lá dentro sem eu perceber.
Esse erro me assusta mais que bug de código, porque chega com cara de norma, com número e tudo.
Então mexi em duas coisas. Cada skill agora separa obrigação legal expressa de boa prática de engenharia, citando o dispositivo. E os números normativos ficam numa referência central, as skills só apontam pra ela.
Também escrevi uma suíte de regressão normativa no CI. Se alguma skill voltar a usar o "> 2 milhões" como limite, ou se uma resolução recente (tipo a 32/2026, de adequação da União Europeia) sumir da referência, o build quebra.
Esse caso ficou coberto. Outros parecidos eu provavelmente ainda vou achar.
O que ele não faz
Ele lê um repositório, e só. Contrato assinado com fornecedor e atendimento respondendo titular no WhatsApp não aparecem no código, então ele não vê. IAM e backup da sua nuvem também ficam de fora.
E não substitui revisão jurídica. No meu caso, quem revisa são as minhas advogadas. (amem?)
Eu fiz as skills pra agilizar esse processo. A ideia é chegar nelas com o mapa de dados e os rascunhos já prontos e versionados, e gastar o tempo delas com as decisões de base legal e retenção. Tem ajudado bastante nos meus projetos.
Um bug que achei esta semana
Revisando o projeto, achei um bug besta no script que extrai as anotações @lgpd: do schema Prisma. O awk exigia /// na coluna zero, e anotação de campo é sempre indentada. Na prática ele ignorava todas.
O exemplo da própria documentação não funcionava, e eu nunca tinha notado (paranoico, mas nem tanto).
Abri como issue pra quem quiser fazer a primeira contribuição, bom, se não fixo mais tarde :D
Pra testar
npx skills add goul4rt/lgpd-skills
Repo: https://github.com/goul4rt/lgpd-skills
Fica uma pergunta pra quem lida com isso no dia a dia: qual vazamento de dado pessoal vocês mais acham em código? Pra mim é log, de longe. Queria saber se tô olhando pro lugar certo.