Pitch: Meus agentes de IA seguiam decisões que eu já tinha abandonado
Quando passei a trabalhar com vários agentes de IA em paralelo, a documentação dos meus projetos começou a crescer mais rápido do que eu conseguia acompanhar. Eu usava Spec-Driven Development: spec e plano antes de cada implementação, tudo numa pasta docs/ junto do código. E registrava cada decisão de arquitetura num ADR, mantendo os antigos, porque sempre gostei de saber por que uma escolha foi feita, mesmo quando ela já não vale mais.
Aí começou o problema.
O agente lê e acredita
De vez em quando, um agente achava um ADR antigo, tomava aquilo como válido e implementava uma regra que eu já tinha abandonado. Mesmo existindo um ADR mais novo. Uma pessoa do time abriria o documento, veria que estava defasado e seguiria em frente. O agente não: ele lê e acredita. Pra mim, o resultado era retrabalho. Desfazer, refazer e pagar os tokens de novo.
Fiz o que quase todo mundo faz: um cabeçalho em cada documento, com status, data e o que substituía o quê. Eu ainda organizava tudo no Obsidian, mas ele não sabe que uma decisão foi substituída; esse estado vivia numa linha de "Status" que ninguém atualizava. Ajudou a organizar, mas não resolveu. Pra saber que um documento estava substituído, o agente precisava abrir e ler o arquivo. Quando descobria, o contexto e os tokens já tinham ido embora. Agora multiplica isso por centenas de documentos, em toda sessão.
Foi aí que caiu a ficha: marcar um documento como obsoleto não tira ele do caminho do agente. O filtro tem que vir antes da leitura, não dentro do arquivo.
O que eu fiz
Escrevi o cerne, uma CLI open source, com interface web local, que separa o que vale hoje do que é histórico. Features, decisões, referências, runbooks e notas têm um estado que só muda por comando, nunca editando texto na mão. Só o que está vigente vai pra pasta .docs/, que é o que o agente lê. O histórico continua guardado e dá pra pesquisar quando precisar.
O primeiro teste de verdade foi na documentação de um produto grande em que eu trabalhava: uns mil arquivos markdown, acumulados em seis meses de desenvolvimento com agentes. O que o agente precisava ler caiu de 1.029 arquivos pra 138. E uma checagem automática achou, em meio segundo, ADRs ativos que ainda citavam decisões substituídas. Era exatamente o problema que eu vinha sentindo, agora visível.
O próprio cerne é desenvolvido com o cerne. Em 18/11, eram 698 registros guardados e só 210 na pasta que o agente lê: em tokens, 97,6% do acervo fora dessa leitura. O número mexe com o trabalho em andamento: hoje, com um épico grande aberto, está em 95%.
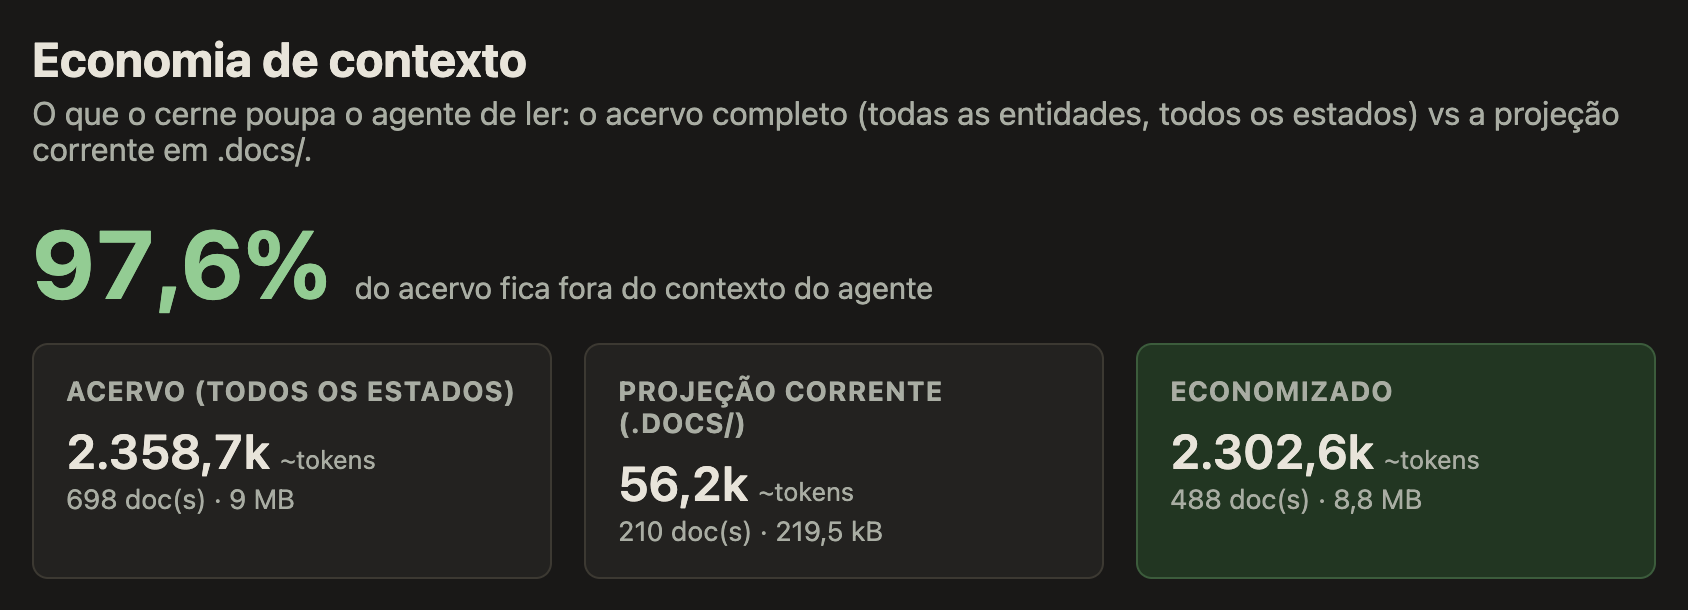
Painel do cerne neste projeto: de uns 2,36 milhões de tokens de documentação, o agente lê por padrão só 56 mil. O resto continua guardado e pesquisável.
O que aprendi no caminho
Estado é dado, não texto. Uma linha "Status: em andamento" no topo do arquivo apodrece. Quando o estado só muda por comando e cada mudança vira um evento, dá pra checar a documentação de forma determinística: um documento que cita uma decisão substituída aparece sem depender do palpite de um modelo.
Corrigir sem apagar. Quando um documento está errado, meu reflexo era reescrever o trecho. Só que aí some o que ele tinha de mais útil: por que o erro parecia certo. Um agente que lê só o texto corrigido pode chegar, do zero, na mesma hipótese que eu já tinha descartado. Hoje a correção entra como errata com data, anexada ao original.
Corrigir a orientação, não só o código. Isso mudou meu jeito de corrigir agente. Correção feita no chat morre no chat. Quando vejo um erro que se repete, em vez de consertar só aquela implementação, registro uma convenção ou uma nota no projeto, e ela vale pra todo agente que vier depois. O cerne também mostra pro agente, na hora em que ele vai editar um arquivo, as notas que citam aquele arquivo.
Nem tudo deu certo
O fluxo sempre foi: o agente escreve a spec, eu aprovo, o agente implementa. Até que, fuçando o histórico do próprio cerne, achei cinco features seguidas aprovadas pelo mesmo agente que tinha escrito as specs. Nada impedia. Hoje, aprovar uma spec e aceitar uma entrega são atos humanos por padrão: o agente escreve, pede aprovação e para.
Outra: planejei uma integração com o Excalidraw pra revisar diagramas durante a aprovação das specs. Depois de 400 features, fui ver quantos diagramas tinham sido salvos: nenhum. Removi, e a interface caiu de 10 MB pra 5,5 MB. Desde então, olhar o que está sendo usado de verdade, e tirar o que não está, virou parte do desenvolvimento.
E quanto custa isso?
Medi em 141 entregas: escrever spec, plano e resultado ficou com 8% dos tokens que o modelo gerou (mediana; entre 4% e 18% em oito de cada dez). O que pesa de verdade é outra coisa: a cada passo, o agente reenvia pro modelo a conversa inteira até ali, com ou sem cerne. Numa feature, isso deu uns 4,5 milhões de tokens lidos, quase tudo do cache, e só uns 5% disso vieram de consultas ao cerne. Sendo honesto: nunca rodei o mesmo trabalho lado a lado, com e sem esse processo. Que ele evita retrabalho é raciocínio meu, não medição.
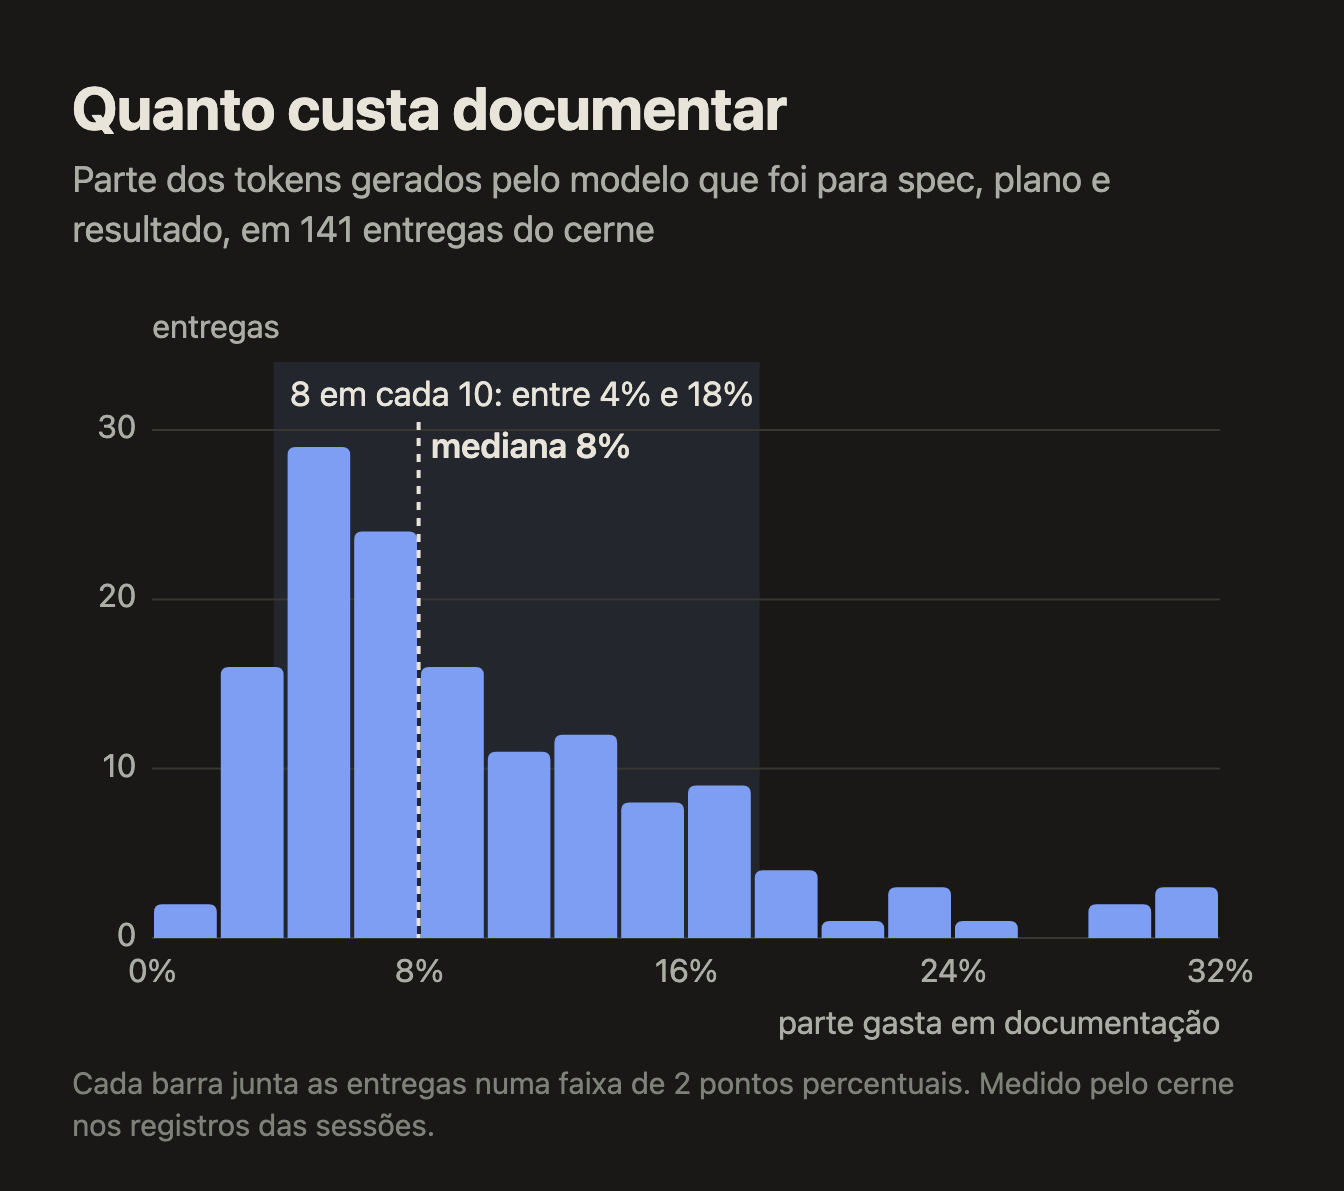
Em 141 entregas, a parte da geração gasta em spec, plano e resultado. Mediana de 8%; em 8 de cada 10 entregas, entre 4% e 18%.
Como funciona e o que ainda não faz
- Um binário só, em Go, que roda local, sem serviço na nuvem. A documentação fica num repositório Git que você escolhe, separado do código.
- A busca no histórico é textual (SQLite FTS5), sem embeddings.
- Testei a fundo com o Claude Code, que é o agente que eu uso. Cursor, Codex CLI e GitHub Copilot têm suporte desde novembro, mas ainda com pouco uso real; o Gemini CLI eu não testei. Como a
.docs/é markdown comum e o cerne é uma CLI, outros agentes conseguem ler a pasta e chamar os comandos, só sem as integrações automáticas. - O código foi escrito 100% por agentes. Meu papel foi decidir o que construir, aprovar as specs e aceitar as entregas.
- Licença Apache 2.0.
Ainda tem muito trabalho pela frente. Resolvi compartilhar porque imagino que mais gente que trabalha pesado com agentes esteja batendo nos mesmos problemas. Se quiser a história completa (como o cerne nasceu e o custo detalhado, com gráficos), escrevi um artigo no LinkedIn.
Pra ver funcionando sem configurar nada: instala com brew install henriquesakata/tap/cerne (no Windows, o script está no README) e roda cerne demo, que monta um projeto de exemplo com histórico em menos de um minuto.
Código e documentação: https://github.com/henriquesakata/cerne
E vocês, como lidam com documentação velha nos projetos com agentes? Quero muito saber o que funcionou e o que não funcionou pra vocês.