Por que a IA do meu agente de automação nunca clica em nada
Faço Engenharia da Computação em Manaus, e há alguns meses comecei um projeto de pesquisa na faculdade: o ANCHOR, um agente de automação web em que você descreve a tarefa em português ("cadastre a Maria Silva no TI, contrato PJ, aceite os termos e salve") e ele executa no navegador. Tudo roda no computador, com modelos de IA locais e pequenos (Qwen 3.5 de 4 e 9 bilhões de parâmetros, pelo Ollama), numa GTX 1050 Ti de 4 GB.
Quero contar aqui a decisão de projeto que mais fez diferença, e algumas coisas que aprendi medindo tudo.
O problema
O RPA tradicional depende de seletores fixos, escritos por um desenvolvedor:
page.locator('[data-test="add-to-cart"]').click()
Funciona enquanto a página não muda, e quebra quando muda. E cada automação precisa de alguém que programe, longe de quem realmente conhece a tarefa.
A solução da moda é deixar um LLM no controle: ele vê a página e decide onde clicar. Mas, com modelos pequenos, isso tem um problema sério, que eu medi (mais abaixo): o modelo diz que terminou sem ter terminado.
A decisão: o modelo só planeja
No ANCHOR, o modelo nunca clica em nada. Ele recebe o pedido e um resumo da página (os elementos, numerados) e devolve um plano: metas e passos, usando os nomes dos elementos ("preencher Nome completo", "marcar PJ", "clicar Salvar cadastro").
Quem executa é um motor determinístico, sem IA:
- Uma heurística encontra cada elemento a partir da descrição do passo, combinando o texto, o rótulo, o papel na página e o contexto (sinônimos, textos próximos), e recusa quando não tem certeza.
- Quando recusa, quem decide é o usuário: os candidatos aparecem numerados na própria página, e você escolhe um (ou clica no certo).
- A escolha fica lembrada: na próxima vez, ele não pergunta.
- O efeito de cada ação é conferido (a página mudou? o campo ficou com o valor? apareceu um erro?), e o fim é conferido contra o pedido.
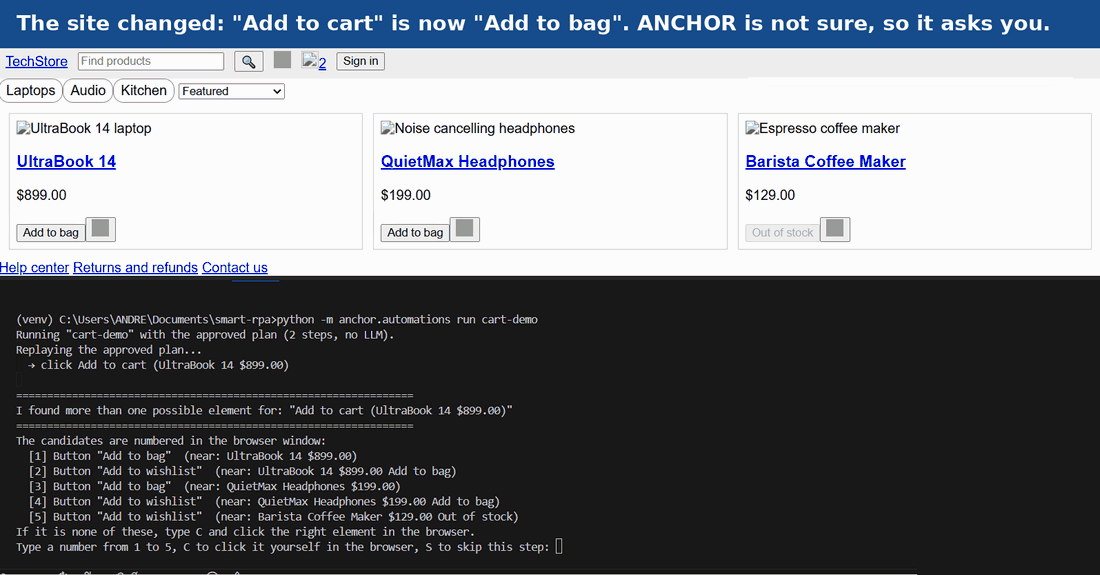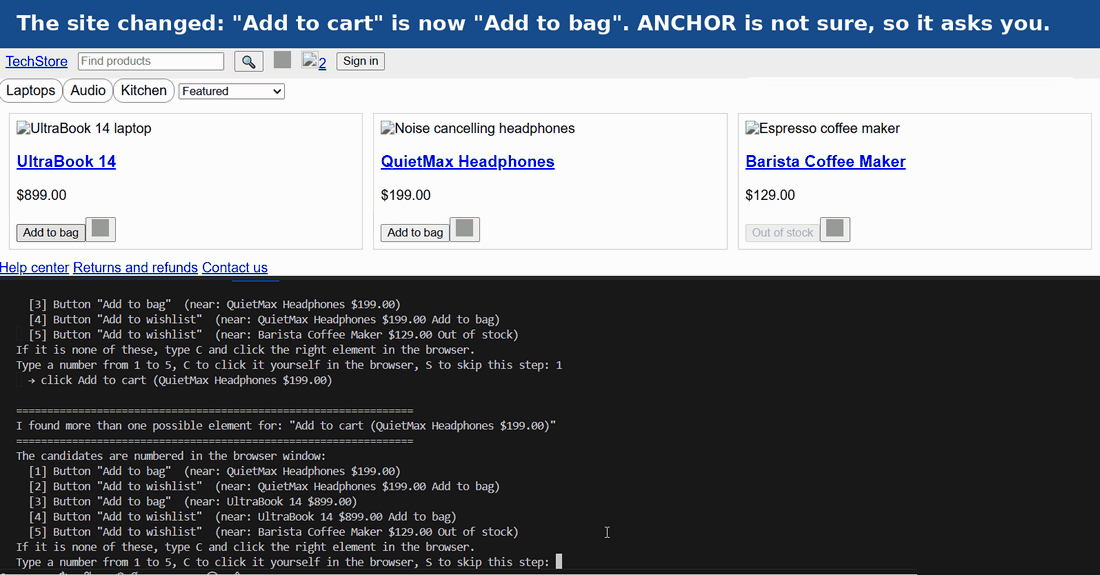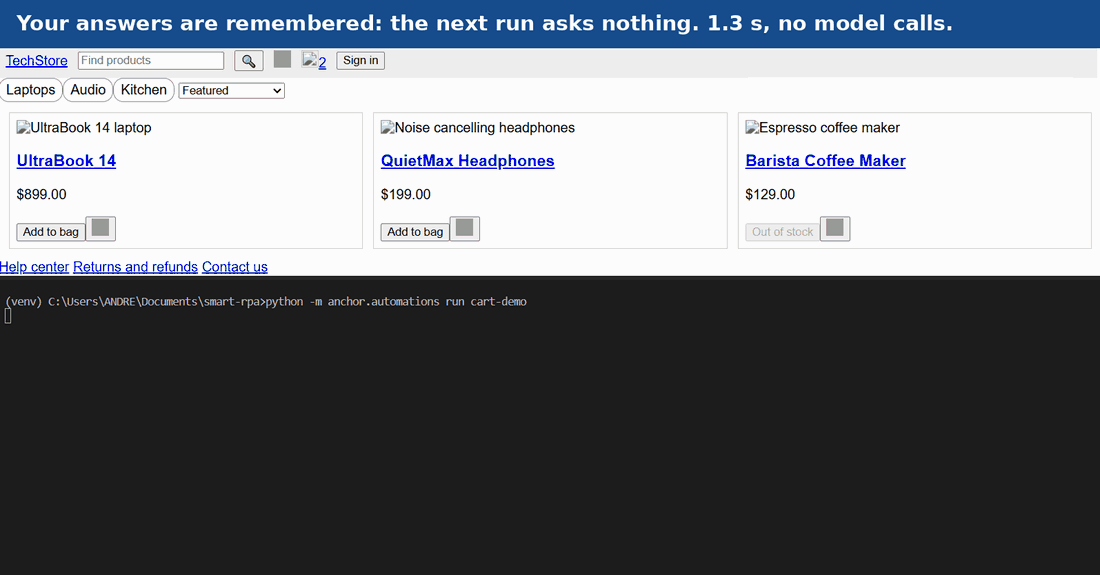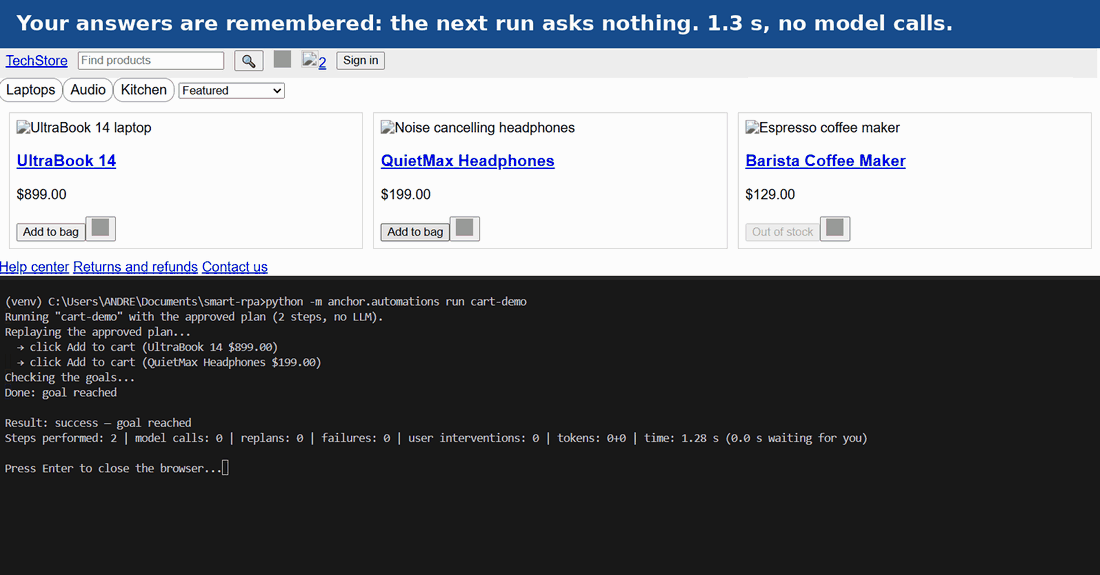
No GIF, o site mudou depois que a automação foi salva ("Add to cart" virou "Add to bag"). Em vez de chutar, o ANCHOR pergunta qual botão usar, lembra da resposta, e a próxima execução roda sozinha.
Aprender uma vez, repetir sem a IA
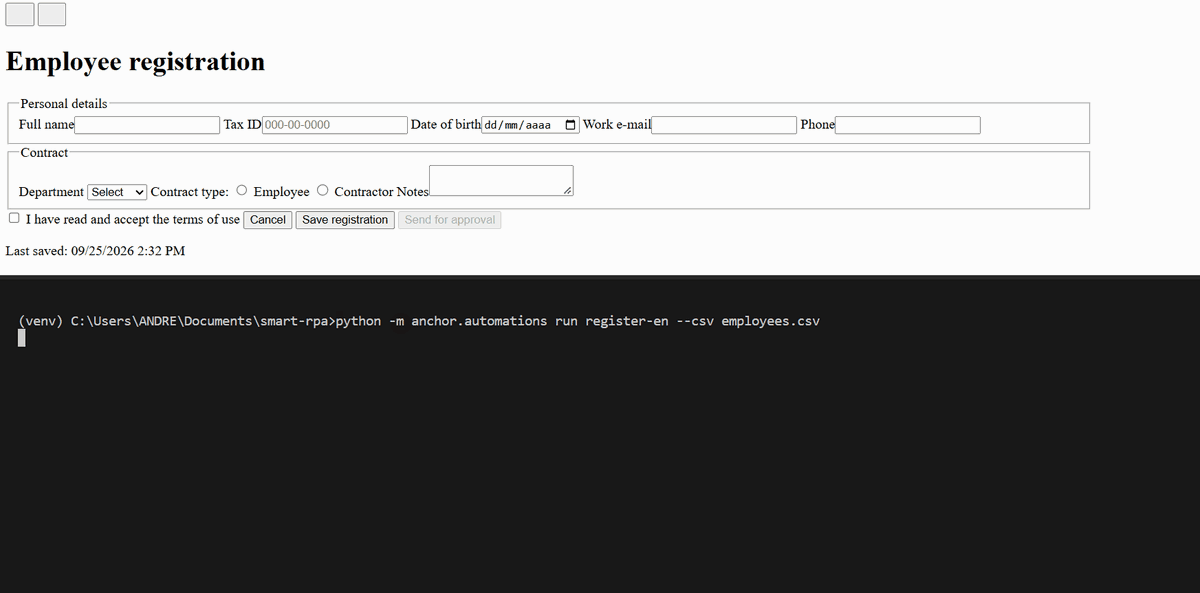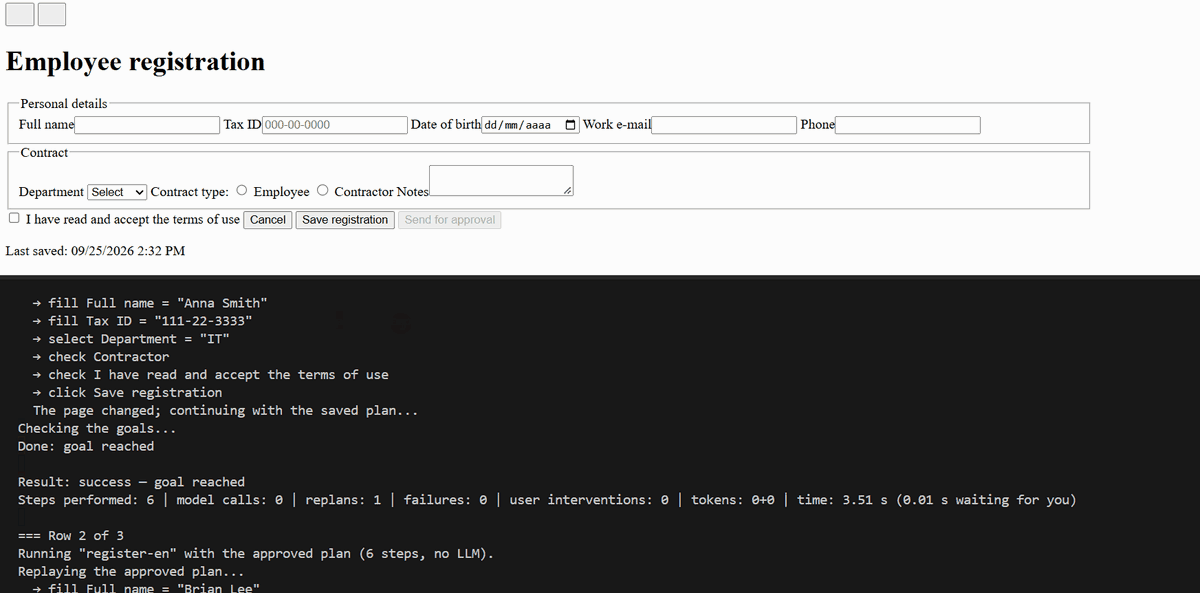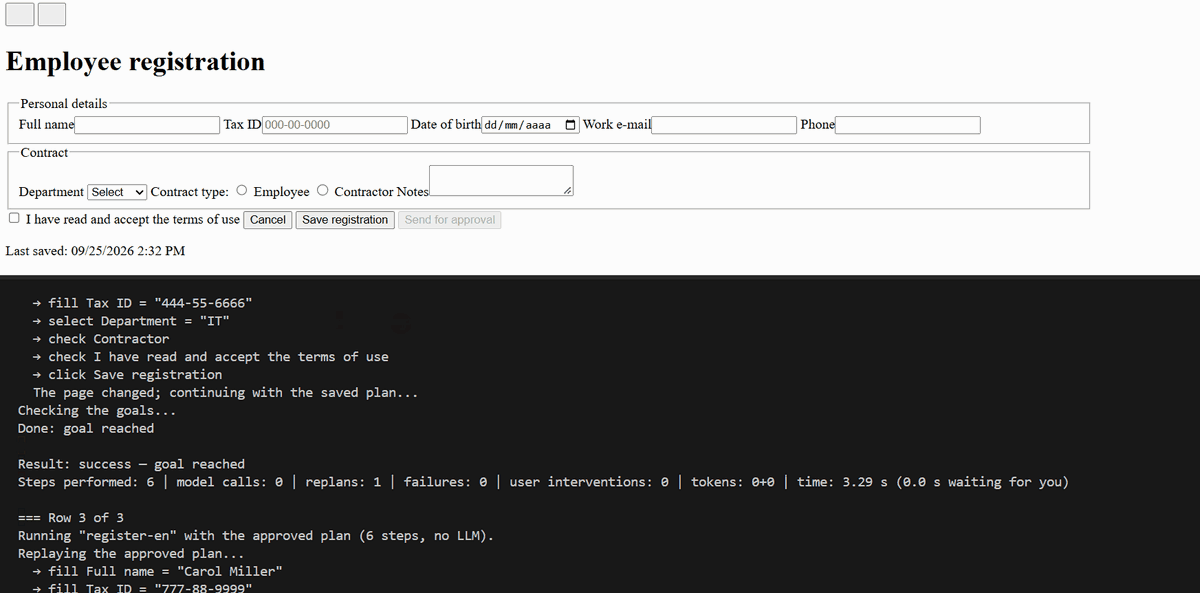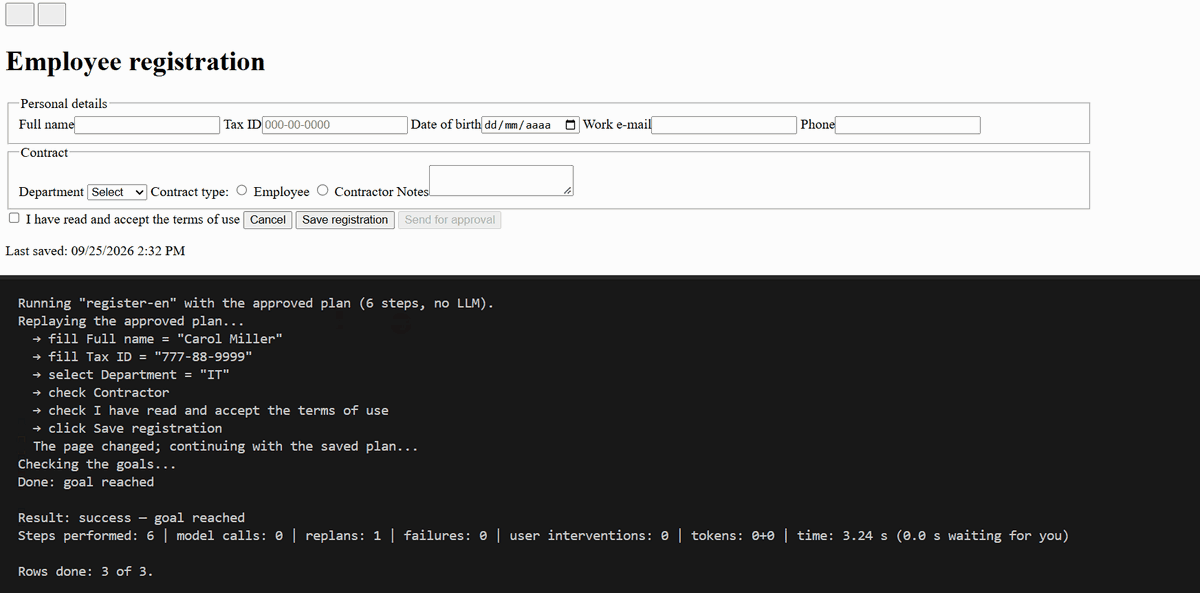
Uma tarefa que deu certo pode ser salva. A primeira execução planeja com o modelo (uns 70 segundos na minha placa); as seguintes repetem o plano aprovado sem chamar o modelo, em cerca de 3 segundos, inclusive uma vez por linha de uma planilha. Quando o site muda e um passo salvo quebra, a automação se recupera e registra o que mudou, e esse registro pode ser revisado e desfeito.
O que as medições mostraram
Montei um benchmark de resiliência: 30 tarefas em páginas alteradas em 5 níveis (IDs trocados, sinônimos, estrutura reorganizada, avisos de cookies e partes escondidas, e elementos-isca com instruções injetadas), 150 execuções por executor e por modelo, sem ninguém para ajudar:
| Executor | Tarefas cumpridas | Sucessos falsos |
|---|---|---|
| Script de seletores fixos (RPA clássico) | 53% | 0 |
| LLM no controle (4B / 9B) | 68% / 72% | 33 / 41 |
| ANCHOR (4B / 9B) | 82% / 84% | 2 / 1 |
A coluna que mais me surpreendeu foi a dos sucessos falsos: o agente com o LLM no controle declarou que tinha cumprido a tarefa, sem ter cumprido, em cerca de uma de cada quatro execuções. Para quem usa a automação, isso é pior do que falhar, porque ninguém fica sabendo.
O ponto fraco do ANCHOR são as páginas com uma parte escondida atrás de um "Mostrar mais" (47%, contra 57% a 60% do LLM no controle). E um aviso honesto: são números do conjunto de desenvolvimento, em que eu ajustei o sistema olhando as tarefas. Para a versão 1.0, há um conjunto fechado de 80 pedidos escritos por colegas que nunca viram o projeto, que só vai rodar uma vez, no fim.
Três lições
1. Medir tudo de novo a cada mudança. A primeira rodada do benchmark revelou quatro falhas que nenhum teste tinha pegado (por exemplo, a barreira contra ações destrutivas deixava passar um "Excluir tudo" quando o pedido era "exclua o Bruno Lima"). E duas das minhas primeiras correções criaram problemas novos, que só apareceram porque eu remedi as outras avaliações também.
2. Uma mudança no prompt afeta tarefas que não têm nada a ver com ela. Quando acrescentei a extração de tabelas, coloquei no prompt duas linhas explicando as ações novas. Resultado: o modelo de 4B começou a parar a busca depois de preencher o campo, e o de 9B esqueceu o tipo de contrato num cadastro. A correção foi mostrar essas linhas só quando o pedido é sobre ler dados; nos outros, o prompt voltou a ser idêntico, byte a byte.
3. Nunca coloque sua senha num pedido para uma IA. Testando no LinkedIn, escrevi meu e-mail e senha no pedido, e ele digitou. A senha não saiu do meu computador, mas passou pelo modelo, o que não devia acontecer. Daí veio a versão 0.3.1: o ANCHOR nunca digita uma senha, barra o pedido com senha antes de chegar ao modelo, e, quando a tarefa precisa de login, para e espera você entrar à mão (a sessão fica guardada para as próximas vezes).
Para testar
O projeto está no GitHub, com o passo a passo de instalação no README:
https://github.com/LucasDantas2701/ANCHOR
Testes e opiniões são muito bem-vindos, principalmente os casos em que ele falha em sites reais: é o feedback que mais ajuda. A próxima versão (0.4) traz download e upload de arquivos, abas novas e iframes.
Transparência: o código foi escrito com ajuda de um assistente de IA (Claude), que também me ajudou a escrever este texto; o projeto, as decisões e a avaliação são meus. O código é aberto para leitura e uso (licença PolyForm Strict), mas não é código aberto no sentido de permitir modificar e redistribuir.