Todo tutorial manda avaliar RAG com Faithfulness, Relevancy e Correctness no mesmo peso. Em produção eu dou o dobro pra Faithfulness
Em quase todo tutorial de RAG você vê a mesma receita: "avalie Faithfulness, Relevancy e Correctness, todas com peso igual". Limpa, simétrica, e furada quando o RAG vai pra um ambiente corporativo.
Em produção, o RAG funciona. A questão passa a ser outra: ele mente ou não? E mentira dentro de uma empresa custa muito mais caro do que uma resposta meio fora do assunto. Então por que avaliar as duas com o mesmo peso?
Olhando como os times de engenharia operam em produção de verdade, o esquema que fecha é outro: 3 eixos com pesos assimétricos, Faithfulness 50%, Relevancy 25%, Correctness 25%. Faithfulness pesa o dobro. E dá pra medir tudo isso sem ground truth, que é o cenário de quase todo projeto real.
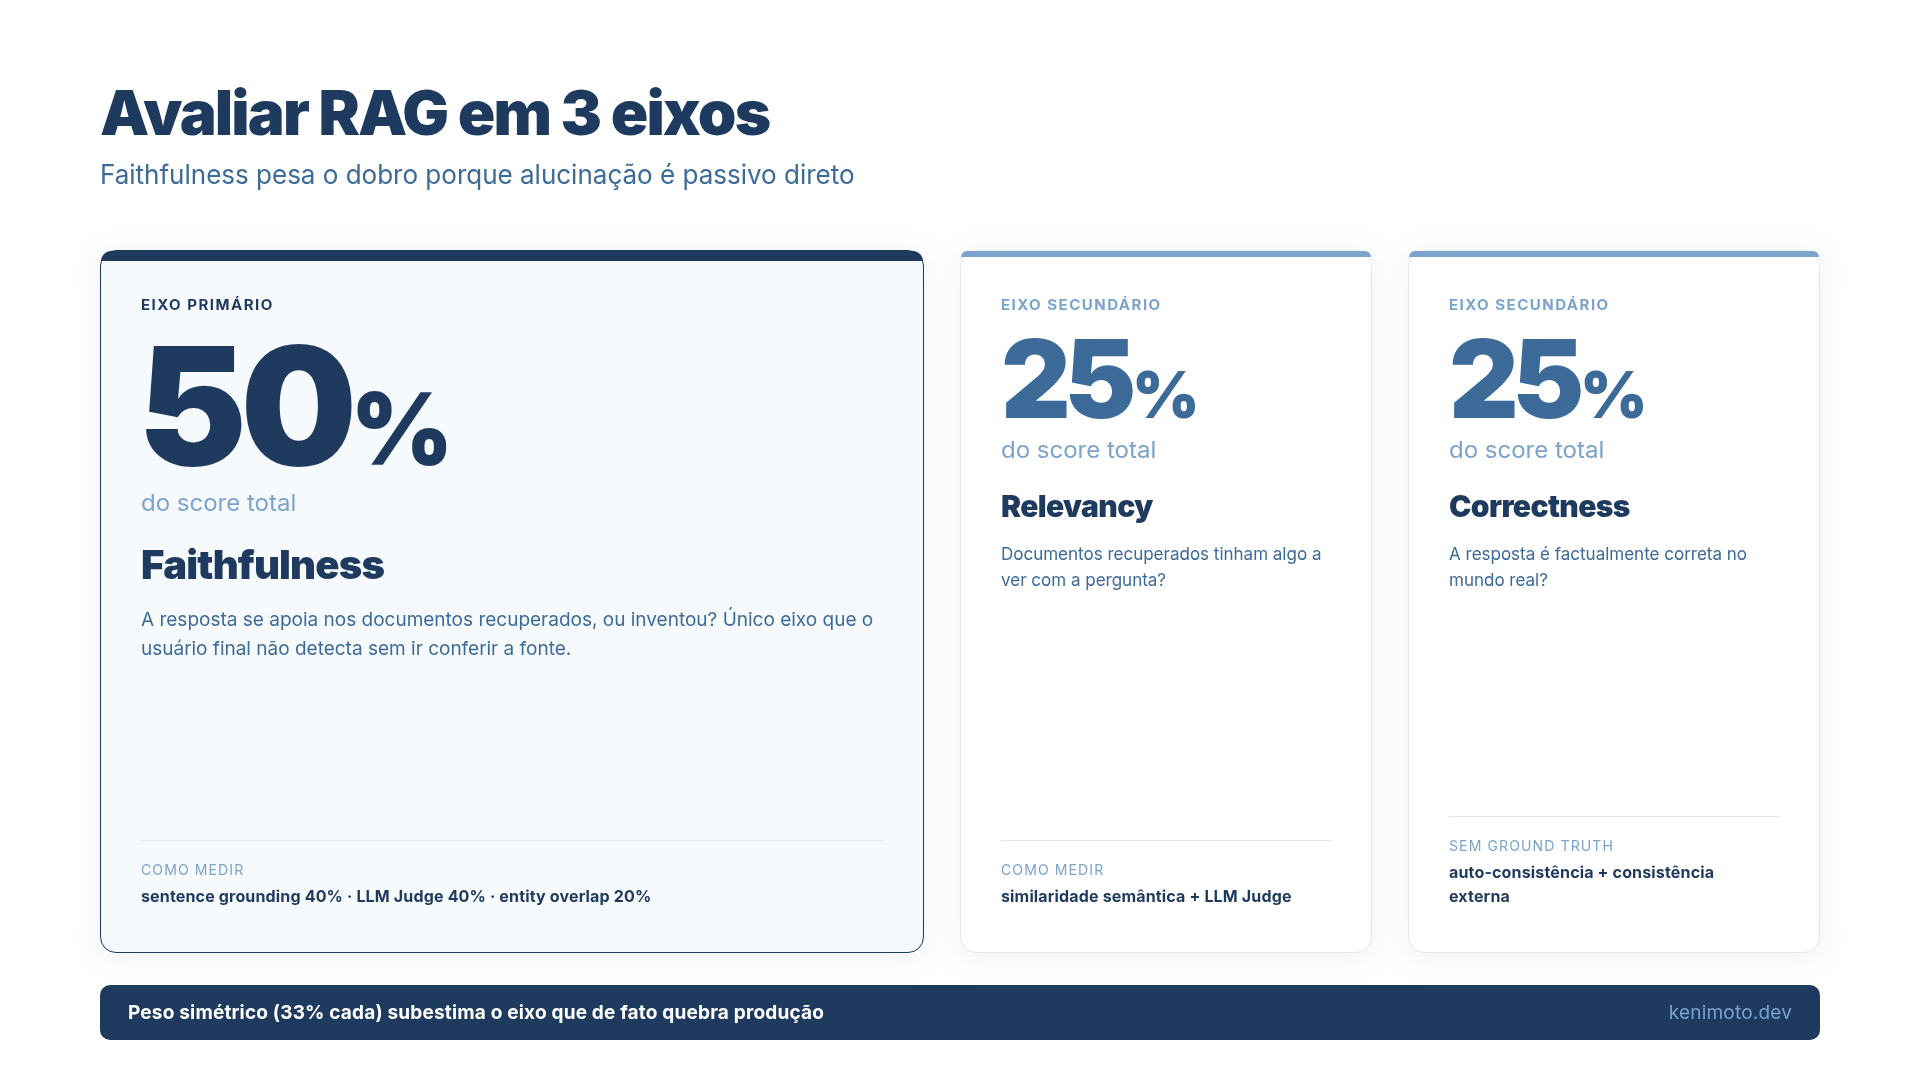
Os 3 eixos, em uma linha cada
- Faithfulness: a resposta se apoia nos documentos recuperados, ou inventou?
- Relevancy: os documentos recuperados tinham alguma coisa a ver com a pergunta?
- Correctness: a resposta é factualmente correta no mundo real?
Os três são necessários. Nenhum substitui o outro. Mas num ambiente corporativo, alucinação é risco de negócio direto: contrato errado, número financeiro inventado, procedimento operacional fabricado. Isso vira passivo da empresa.
Por isso Faithfulness pesa o dobro no esquema que eu recomendo.
Por que Faithfulness 50% e não 33%
Pensa no pior caso de cada eixo:
| Eixo quebrado | Pior caso em produção |
|---|---|
| Faithfulness baixa | Agente inventa um número, usuário age em cima disso |
| Relevancy baixa | Agente responde "não encontrei" — chato, mas honesto |
| Correctness baixa | Agente confia num documento desatualizado |
Faithfulness baixa produz mentira autoritária. É o único dos três que o usuário final só consegue detectar indo conferir a fonte, ou seja, exatamente o passo que o RAG prometeu eliminar.
Relevancy baixa é detectável ("isso não é o que perguntei"). Correctness baixa é rastreável (a fonte existe, está só errada). Faithfulness baixa é invisível. Dobrar o peso faz sentido justamente por isso.
Como medir Faithfulness (combinando 3 técnicas)
Uma técnica sozinha deixa buraco. O padrão que funciona combina três:
faithfulness_score =
    sentence_level_grounding × 0.4
  + LLM_Judge_overall       × 0.4
  + entity_overlap_rate     × 0.2
Sentence-level grounding (40%)
Quebra a resposta em frases. Pra cada frase, checa se existe uma relação de implicação (entailment) com o contexto recuperado. Modelo clássico de NLI faz isso rápido, mas um LLM também serve se você aceitar o custo.
Frase sem ancoragem explícita no contexto = alucinação candidata.
LLM Judge (40%)
Um segundo LLM lê a resposta inteira e o contexto, e pontua "quanto da resposta vem de fato do contexto" numa escala 0-1. É mais caro, mas captura padrões que o grounding por frase perde (por exemplo, quando a resposta cita um número que combina 3 trechos).
Peso igual ao grounding por frase porque os dois erram em padrões diferentes. A média estabiliza o resultado.
Entity overlap (20%)
Extrai entidades nomeadas (nomes de produto, datas, valores, pessoas) da resposta e checa se elas aparecem no contexto. Leve, rápido, pega alucinação de entidade específica (o modelo trocou "Pinecone" por "Weaviate").
Peso menor porque é raso. Em compensação, é o detector mais barato de rodar e pega um tipo de erro que os outros dois às vezes deixam passar.
O problema real: você não tem ground truth
Em quase todo projeto corporativo não existe uma lista de "perguntas com resposta anotada por humano". Então Correctness, do jeito que os tutoriais acadêmicos ensinam (comparar com ground truth), fica inviável de cara.
O que funciona é substituir ground truth por 4 métricas indiretas, com pesos novamente assimétricos:
| Métrica alternativa | O que mede | Peso |
|---|---|---|
| Auto-consistência | Rodar a mesma pergunta N vezes e medir variância | 30% |
| Cobertura | Até que ponto a resposta cobre a intenção (LLM Judge) | 25% |
| Consistência externa | Zero contradições com fatos conhecidos | 25% |
| Clareza | Estrutura e legibilidade da resposta | 20% |
Auto-consistência leva o peso maior porque é o único que o sistema pode calcular sozinho. Se você faz a mesma pergunta 5 vezes e recebe 5 respostas diferentes, não precisa de ground truth pra saber que tem problema.
Consistência externa é onde entra um pequeno conjunto de "fatos canônicos" da empresa. Não precisa ser um ground truth completo: bastam os 50 ou 100 fatos que você sabe que estão certos. Qualquer resposta que contradiga esse conjunto é vermelho imediato.
Pipeline mínimo pra montar
- Monte um conjunto de teste com três tipos de pergunta: fáceis factuais, perguntas que exigem múltiplos documentos, e perguntas sem resposta
- Rode as consultas em paralelo
- Calcule os 3 eixos com os pesos acima
- Acompanhe os resultados ao longo do tempo pra detectar regressão
O terceiro tipo de pergunta (sem resposta no corpus) é o mais importante e o mais ignorado. Se o seu RAG inventa uma resposta pra uma pergunta que ele não devia saber, o Faithfulness desse caso é zero, e você precisa penalizar forte.
O resumo que importa
O esquema "33% pra cada eixo" é confortável porque é simétrico. Mas em RAG corporativo, o eixo que mata é Faithfulness, e o peso precisa refletir isso.
Se o seu time já tem um RAG rodando e nunca mediu os 3 eixos separadamente, o ganho fácil está aqui: passe Faithfulness pra 50% no cálculo, troque ground truth pelas 4 métricas indiretas, e comece a registrar o score ao longo do tempo. A primeira semana já expõe onde o sistema está mentindo.
E mentir, dentro de uma empresa, vira passivo. Fica no balanço.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews