Territórios de vendas balanceados em Python: divida leads por carga de trabalho, não por área do mapa
Você tem uma lista de leads com endereço e um time de vendas externo para cobrir a cidade. A reação instintiva é abrir o mapa e traçar uma linha no meio: "você fica com o norte, você com o sul". Parece um problema de geometria. Não é. É um problema de balanceamento de carga, da mesma família de distribuir jobs entre workers: o que deve ficar igual é a quantidade de trabalho de cada lado, e o mapa é só a visualização disso.
O erro está em assumir que áreas iguais no mapa contêm quantidades parecidas de oportunidade. Negócios não se distribuem uniformemente. Este artigo resolve o problema em duas camadas: primeiro dividindo bairros inteiros entre vendedores (partição greedy + trocas), depois atribuindo lead a lead com distância haversine e um teto de capacidade. Todo o código abaixo foi executado, e os outputs mostrados são os que o código imprime.
Por que área igual no mapa não é oportunidade igual
A forma óbvia de dividir uma cidade entre dois vendedores é riscar o mapa, ou distribuir bairros até cada lado ficar com o mesmo número deles. Parece justo porque as entradas parecem iguais. Não são. Os números a seguir vêm do próprio guia de planejamento de territórios do Mantis e cobrem as áreas de Jaipur, na Índia, onde mais de trinta negócios foram verificados: "sem site" são os prospects (negócios locais sem site próprio), e "verificados" é o total checado em cada área.
| Área | Sem site | Verificados | Taxa sem site |
|---|---|---|---|
| Mansarovar | 182 | 410 | 44,4% |
| Vaishali Nagar | 102 | 388 | 26,3% |
| Ashok Nagar | 75 | 249 | 30,1% |
| Jagatpura | 69 | 156 | 44,2% |
| Malviya Nagar | 64 | 218 | 29,4% |
| Raja Park | 57 | 132 | 43,2% |
| Sanganer | 53 | 103 | 51,5% |
| Pratap Nagar | 37 | 83 | 44,6% |
As oito áreas somam 639 prospects, e Mansarovar sozinha concentra 182 deles. A taxa de negócios sem site varia de 26,3% a 51,5% entre áreas. Ou seja, uma divisão pelo mapa pode entregar a um vendedor o maior bolso de prospects da cidade e deixar o outro com o lado vazio. A correção cabe numa frase do guia: meça a densidade antes de atribuir qualquer coisa e divida por densidade e categoria, não por geografia.
Parte 1: round-robin vs. greedy LPT vs. greedy + trocas
Em código, cada área vira uma tupla (nome, prospects, verificados) e a unidade de trabalho é a contagem de prospects. Três estratégias sobre essa tabela: o rodízio ingênuo, uma partição greedy clássica de scheduling e a greedy seguida de uma busca local por trocas.
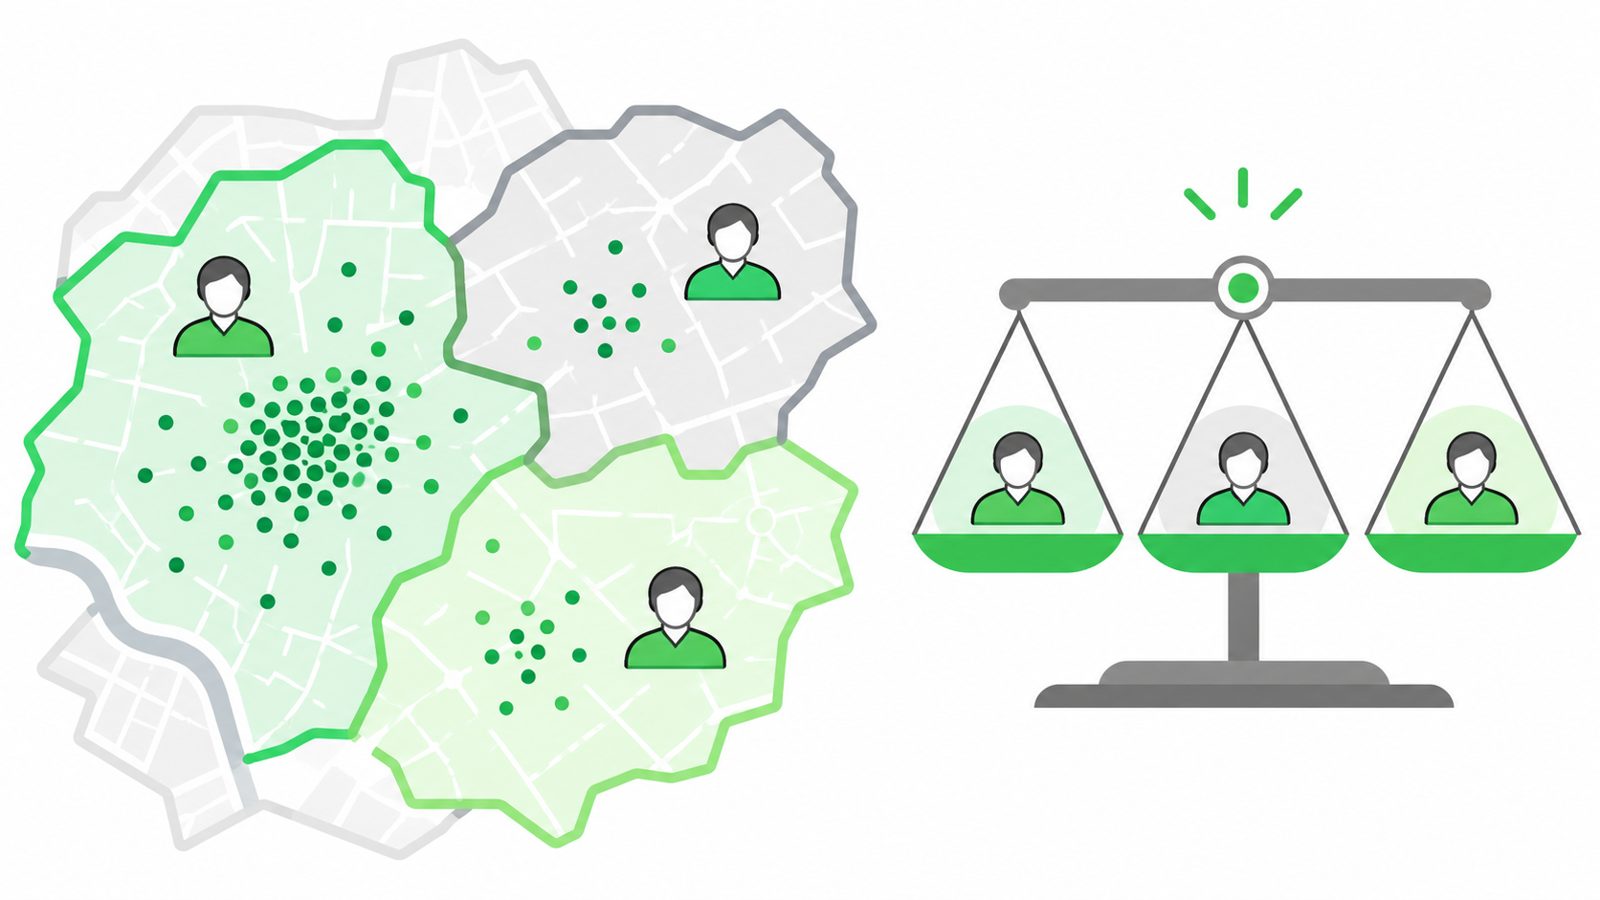
Ilustração gerada por IA.
O round-robin distribui as áreas na ordem da lista — primeira para o vendedor 0, segunda para o 1, e recomeça. É o que uma divisão rápida no papel faz na prática: ignora o tamanho e torce para a ordem ser amigável. O greedy é o LPT (longest processing time), heurística clássica de escalonamento: ordene as áreas da maior para a menor e entregue cada uma ao vendedor com menos carga no momento; um heap de pares (carga, vendedor) acha esse mínimo de forma barata. Áreas grandes entram cedo, quando todos estão vazios; as pequenas chegam por último e caem no lado mais leve.
import heapq

# (área, negócios sem site, negócios verificados)
areas = [
    ("Mansarovar", 182, 410), ("Vaishali Nagar", 102, 388),
    ("Ashok Nagar", 75, 249), ("Jagatpura", 69, 156),
    ("Malviya Nagar", 64, 218), ("Raja Park", 57, 132),
    ("Sanganer", 53, 103), ("Pratap Nagar", 37, 83),
]

def split_round_robin(areas, reps):
    """Distribui as áreas em rodízio, como uma divisão rápida no papel."""
    out = {r: [] for r in range(reps)}
    for i, a in enumerate(areas):
        out[i % reps].append(a)
    return out

def split_greedy(areas, reps):
    """LPT: maior área primeiro, sempre para o vendedor com menos carga."""
    heap = [(0, r) for r in range(reps)]          # (carga, vendedor)
    out = {r: [] for r in range(reps)}
    for a in sorted(areas, key=lambda a: a[1], reverse=True):
        carga, r = heapq.heappop(heap)
        out[r].append(a)
        heapq.heappush(heap, (carga + a[1], r))
    return out

def report(nome, split):
    print(nome)
    for r, lst in split.items():
        prospects = sum(a[1] for a in lst)
        nomes = ", ".join(a[0] for a in lst)
        print(f"  vendedor {r}: {prospects:>3} prospects  [{nomes}]")
Rodando as três divisões:
report("round-robin", split_round_robin(areas, 2))
report("greedy", split_greedy(areas, 2))
report("greedy, 3 vendedores", split_greedy(areas, 3))
round-robin
  vendedor 0: 374 prospects  [Mansarovar, Ashok Nagar, Malviya Nagar, Sanganer]
  vendedor 1: 265 prospects  [Vaishali Nagar, Jagatpura, Raja Park, Pratap Nagar]
greedy
  vendedor 0: 303 prospects  [Mansarovar, Malviya Nagar, Raja Park]
  vendedor 1: 336 prospects  [Vaishali Nagar, Ashok Nagar, Jagatpura, Sanganer, Pratap Nagar]
greedy, 3 vendedores
  vendedor 0: 219 prospects  [Mansarovar, Pratap Nagar]
  vendedor 1: 219 prospects  [Vaishali Nagar, Malviya Nagar, Sanganer]
  vendedor 2: 201 prospects  [Ashok Nagar, Jagatpura, Raja Park]
O rodízio termina em 374 contra 265 — uma diferença de 109 prospects causada apenas pela ordem em que as áreas apareceram na lista. O greedy fecha em 303 contra 336, diferença de 33; o que sobra é granularidade, porque o lado que recebe Mansarovar (182 prospects sozinha) restringe todo o resto. Com três vendedores, o greedy dá 219, 219 e 201.
Para fechar a diferença, uma busca local curta: para cada par de vendedores, tente transferir uma área de um lado para o outro ou trocar uma área por outra; aceite o movimento se ele reduzir estritamente a diferença do par e pare quando uma passada completa não melhorar nada. No código, None significa "nenhuma área", então emparelhar uma área real com None transforma o loop de troca num loop de movimentação de graça:
from itertools import combinations

def carga(lst):
    return sum(a[1] for a in lst)

def melhora(split):
    """Troca ou move áreas entre vendedores enquanto isso reduzir a diferença."""
    mudou = True
    while mudou:
        mudou = False
        for r1, r2 in combinations(split, 2):
            gap = abs(carga(split[r1]) - carga(split[r2]))
            for a in split[r1] + [None]:
                for b in split[r2] + [None]:
                    if a is None and b is None:
                        continue
                    da = a[1] if a else 0
                    db = b[1] if b else 0
                    novo = abs((carga(split[r1]) - da + db) - (carga(split[r2]) - db + da))
                    if novo < gap:
                        if a: split[r1].remove(a); split[r2].append(a)
                        if b: split[r2].remove(b); split[r1].append(b)
                        mudou = True
                        break
                if mudou: break
            if mudou: break
    return split
greedy + trocas
  vendedor 0: 321 prospects  [Mansarovar, Ashok Nagar, Malviya Nagar]
  vendedor 1: 318 prospects  [Vaishali Nagar, Jagatpura, Sanganer, Pratap Nagar, Raja Park]
greedy + trocas, 3 vendedores
  vendedor 0: 219 prospects  [Mansarovar, Pratap Nagar]
  vendedor 1: 212 prospects  [Vaishali Nagar, Sanganer, Raja Park]
  vendedor 2: 208 prospects  [Ashok Nagar, Jagatpura, Malviya Nagar]
O total é 639, um número ímpar, então uma divisão perfeitamente igual em dois lados não existe. A busca termina em 321 contra 318 — diferença de 3, contra 33 do greedy puro. Com três vendedores, fecha em 219, 212 e 208, um spread de 11 no time. Além disso não compensa ajustar: o desequilíbrio restante já é menor que uma única área pequena.
Parte 2: lead a lead, com haversine e teto de capacidade
Bairro é uma unidade grosseira. Se a lista tem latitude e longitude por linha, dá para pular as áreas e atribuir leads individuais. O objetivo não muda — contagens iguais — mas entra um segundo eixo: deslocamento, com cada lead indo para um vendedor perto dele. E scikit-learn sozinho resolve a parte geo, sem stack geoespacial.
A atribuição tem quatro peças:
- Sementes. k sementes representam os k vendedores. A primeira é o lead mais denso:
BallTree+query_radiuscomcount_only=True, que devolve quantos pontos estão dentro do raio r para cada ponto. Com r de um quilômetro (1.0 / EARTH_KMna esfera unitária), o argmax é o lead com mais vizinhos por perto. (A métricahaversineé válida naBallTreedo scikit-learn 1.9.1.) As demais vêm do farthest-point seeding: pegue repetidamente o lead mais distante da semente mais próxima já escolhida, o que espalha as sementes pelo mapa em vez de empilhá-las num hotspot só. - Distâncias. Uma chamada a
haversine_distances(X, X[sementes]) * EARTH_KMdevolve uma matriz (n_leads, k) em quilômetros. - Capacidade. O teto é
ceil(n / k): com 300 leads e três vendedores, exatamente 100 para cada. Sem ele, todo lead vai para a semente mais próxima e as contagens escorrem. - Ordem de arrependimento. Se os leads forem atendidos na ordem das linhas, os do começo pegam vagas de que os do fim precisam mais. Então cada lead recebe um score: distância até a segunda semente mais próxima menos a distância até a mais próxima. Quem tem uma semente perto e outra longe tem muito a perder se a perto encher, então vai primeiro. Nessa ordem, cada lead fica com a semente mais próxima que ainda tem vaga.
Os dados da demo são sintéticos: 300 pontos aleatórios em três blobs de 160, 90 e 50 leads ao redor de um centro, gerados com a seed 7 do numpy para que o output reproduza exatamente:
import math
import numpy as np
from sklearn.metrics.pairwise import haversine_distances
from sklearn.neighbors import BallTree

EARTH_KM = 6371.0

# Demo sintética: 300 leads em três blobs de tamanhos diferentes ao redor de um centro.
rng = np.random.default_rng(7)
centro = np.array([26.90, 75.79])                 # lat, lon em graus
blobs = [(centro + [0.00, 0.00], 0.020, 160),
         (centro + [0.05, 0.04], 0.015, 90),
         (centro + [-0.06, 0.03], 0.012, 50)]
leads_graus = np.vstack([c + rng.normal(0, s, (n, 2)) for c, s, n in blobs])
leads = np.radians(leads_graus)                   # sklearn quer [lat, lon] em radianos

def escolhe_sementes(X, k):
    """Farthest-point seeding: começa no lead mais denso, depois pega o mais distante."""
    tree = BallTree(X, metric="haversine")
    densidade = tree.query_radius(X, r=1.0 / EARTH_KM, count_only=True)  # leads num raio de 1 km
    sementes = [int(np.argmax(densidade))]
    for _ in range(k - 1):
        d = haversine_distances(X, X[sementes]).min(axis=1)
        sementes.append(int(np.argmax(d)))
    return sementes

def atribui(X, k):
    sementes = escolhe_sementes(X, k)
    dist = haversine_distances(X, X[sementes]) * EARTH_KM   # (n_leads, k) em km
    cap = math.ceil(len(X) / k)
    # Quem mais perde com uma má atribuição vai primeiro (ordem de "arrependimento").
    srt = np.sort(dist, axis=1)
    ordem = np.argsort(-(srt[:, 1] - srt[:, 0]))
    dono = np.full(len(X), -1)
    carga = [0] * k
    for i in ordem:
        for rep in np.argsort(dist[i]):
            if carga[rep] < cap:
                dono[i] = rep
                carga[rep] += 1
                break
    return dono, dist

def resumo(dono, dist, k, rotulo):
    print(rotulo)
    for rep in range(k):
        mask = dono == rep
        km = dist[mask, rep]
        print(f"  vendedor {rep}: {mask.sum():>3} leads, mediana {np.median(km):.1f} km, máx {km.max():.1f} km")

k = 3
dono, dist = atribui(leads, k)
resumo(dono, dist, k, "com capacidade")

mais_prox = dist.argmin(axis=1)          # mesmas sementes, sem capacidade
resumo(mais_prox, dist, k, "só semente mais próxima")
com capacidade
  vendedor 0: 100 leads, mediana 1.6 km, máx 4.9 km
  vendedor 1: 100 leads, mediana 4.6 km, máx 9.6 km
  vendedor 2: 100 leads, mediana 4.7 km, máx 13.5 km
só semente mais próxima
  vendedor 0: 170 leads, mediana 2.4 km, máx 5.9 km
  vendedor 1:  77 leads, mediana 4.2 km, máx 6.6 km
  vendedor 2:  53 leads, mediana 2.8 km, máx 5.4 km
Os dois blocos contam uma história só. Sem teto, a atribuição pela semente mais próxima distribui 170, 77 e 53 leads — uma semente fica com mais de três vezes a carga de outra. O deslocamento parece ótimo (medianas de 2,4, 4,2 e 2,8 km; máximos de 5,9, 6,6 e 5,4 km), mas as cargas são inutilizáveis. Com o teto, cada vendedor recebe exatamente 100 leads; as medianas vão para 1,6, 4,6 e 4,7 km e os máximos para 4,9, 9,6 e 13,5 km — o do primeiro vendedor cai, o dos outros dois sobe. Contagens iguais custam quilômetros: o lead mais distante de um dos vendedores agora está a 13,5 km.
Armadilhas
Dois detalhes de API que causam erros silenciosos:
- Ordem e unidade das coordenadas.
haversine_distancesespera [latitude, longitude], nessa ordem, em radianos, em duas colunas. Passar graus em vez de radianos dá distâncias erradas. Por isso onp.radianslogo na entrada. - Esfera unitária. As distâncias voltam numa esfera de raio 1; a documentação do scikit-learn multiplica pelo raio da Terra, 6371 km, para obter quilômetros. É o que o
EARTH_KMfaz no código. Esqueça isso e seus "quilômetros" estarão em radianos.
E duas ressalvas sobre o método:
- O farthest-point seeding pode escolher um outlier: um lead isolado na borda do mapa é longe de tudo por definição, e transformá-lo em semente constrói um território em cima de ruído. Se isso importar nos seus dados, recalcule cada semente como a mediana dos leads que ela possui e rode a atribuição de novo.
- Os pontos da Parte 2 são sintéticos — três blobs com seed fixa, escolhidos para deixar o trade-off visível, não para modelar nenhuma cidade real.
Conclusão
Dividir uma cidade entre vendedores é scheduling, não geometria. O método cabe em três passos: meça a densidade antes de atribuir qualquer coisa; se a unidade for o bairro, use a partição greedy seguida de trocas (na tabela de Jaipur, a diferença cai de 33 para 3); se a unidade for o lead, use atribuição por haversine com teto de capacidade, pagando alguns quilômetros a mais em troca de cargas exatamente iguais. E se dez leads frios não valem dez leads quentes no seu funil, troque a contagem pelo peso de cada item — as mesmas funções balanceiam a soma dos pesos.
A versão sem código desse argumento, com divisão por categoria, está no guia de planejamento de territórios do Mantis (em inglês).
Sou o Tarun, fundador do Mantis (I'm Tarun, founder of Mantis).