Estou construindo uma ferramenta de trabalho e chamadas que fica no seu servidor e que nem eu consigo ler (open source, preciso de feedback)
Fala, pessoal.
Esse é um post de apresentação, e já aviso que também é um pedido de ajuda. Vou contar o que estou construindo, mostrar como está hoje (com prints e um vídeo curto) e no final dizer exatamente onde eu preciso de vocês.
O problema
Equipe pequena que toca vários microSaaS acaba com o trabalho espalhado: tarefa num lugar, conversa em outro, chamada em um terceiro, arquivo em um quarto. E tudo isso passa por servidores de terceiros, que enxergam cada mensagem, cada anexo, cada nome de projeto.
Eu fiquei me perguntando: e se fosse uma ferramenta só, pequena, que você sobe no seu próprio servidor e que o servidor não consegue ler?
Daí nasceu o Crewstead.
O que é
Uma ferramenta web de colaboração para equipes pequenas, com:
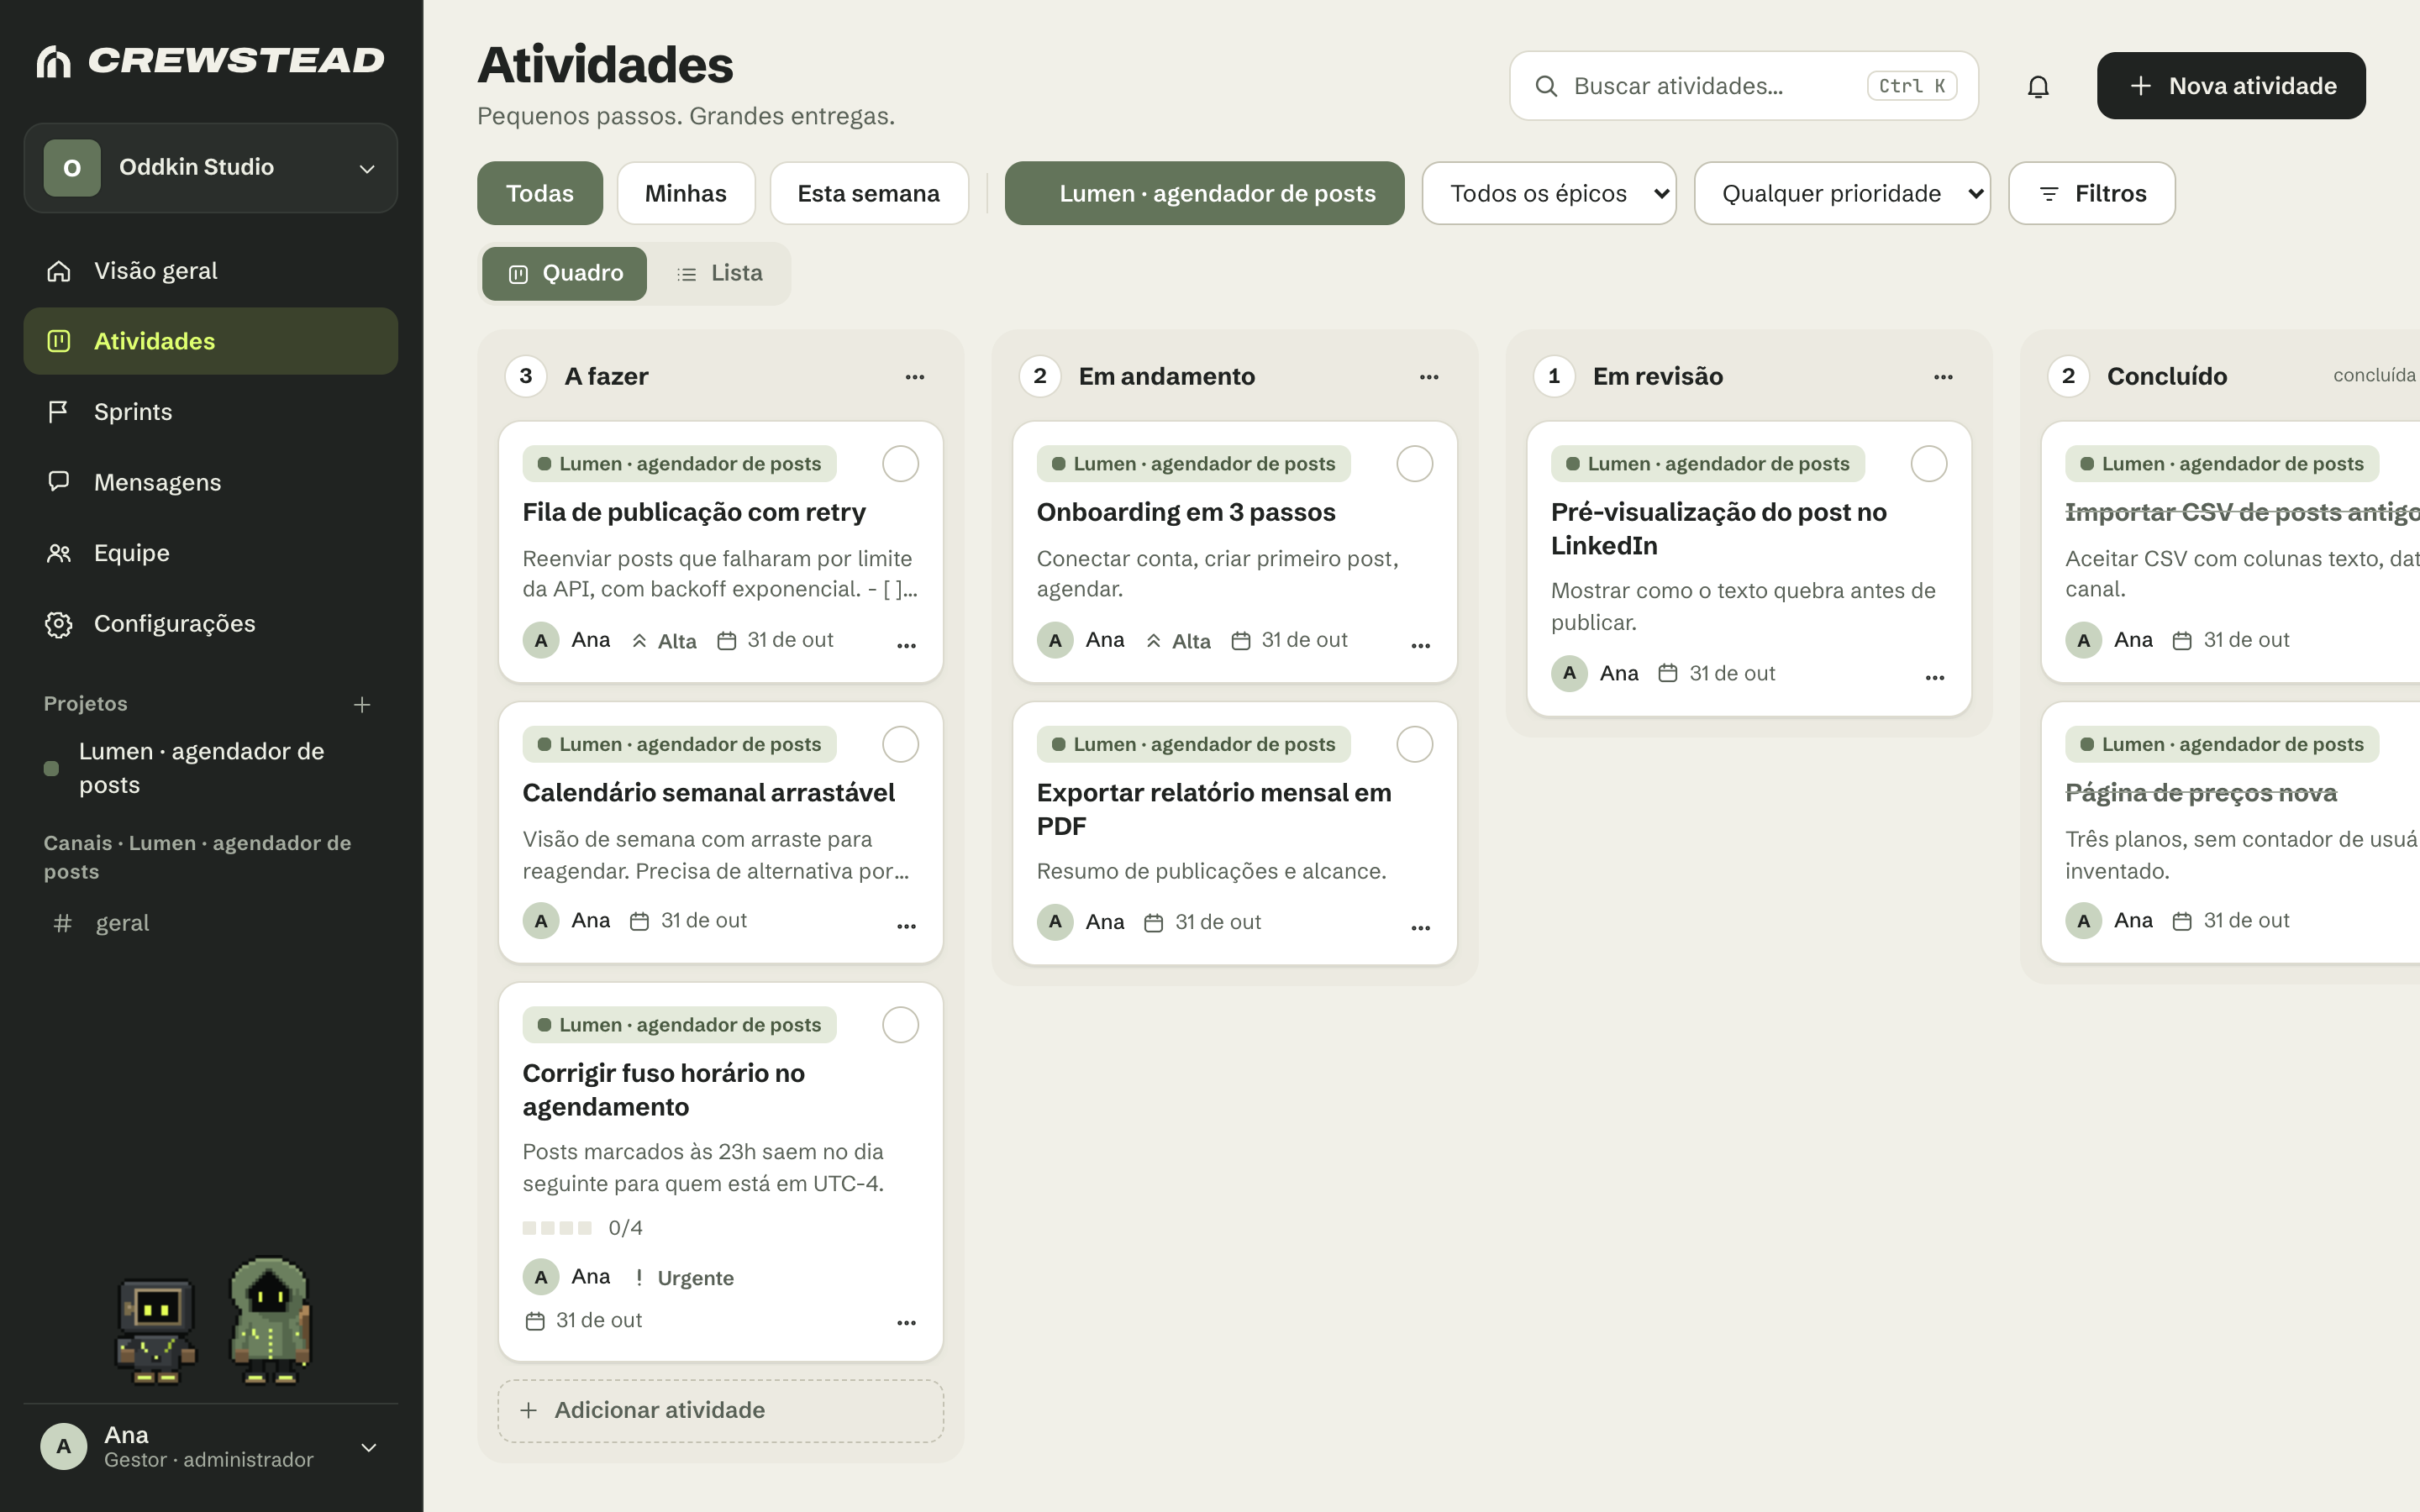
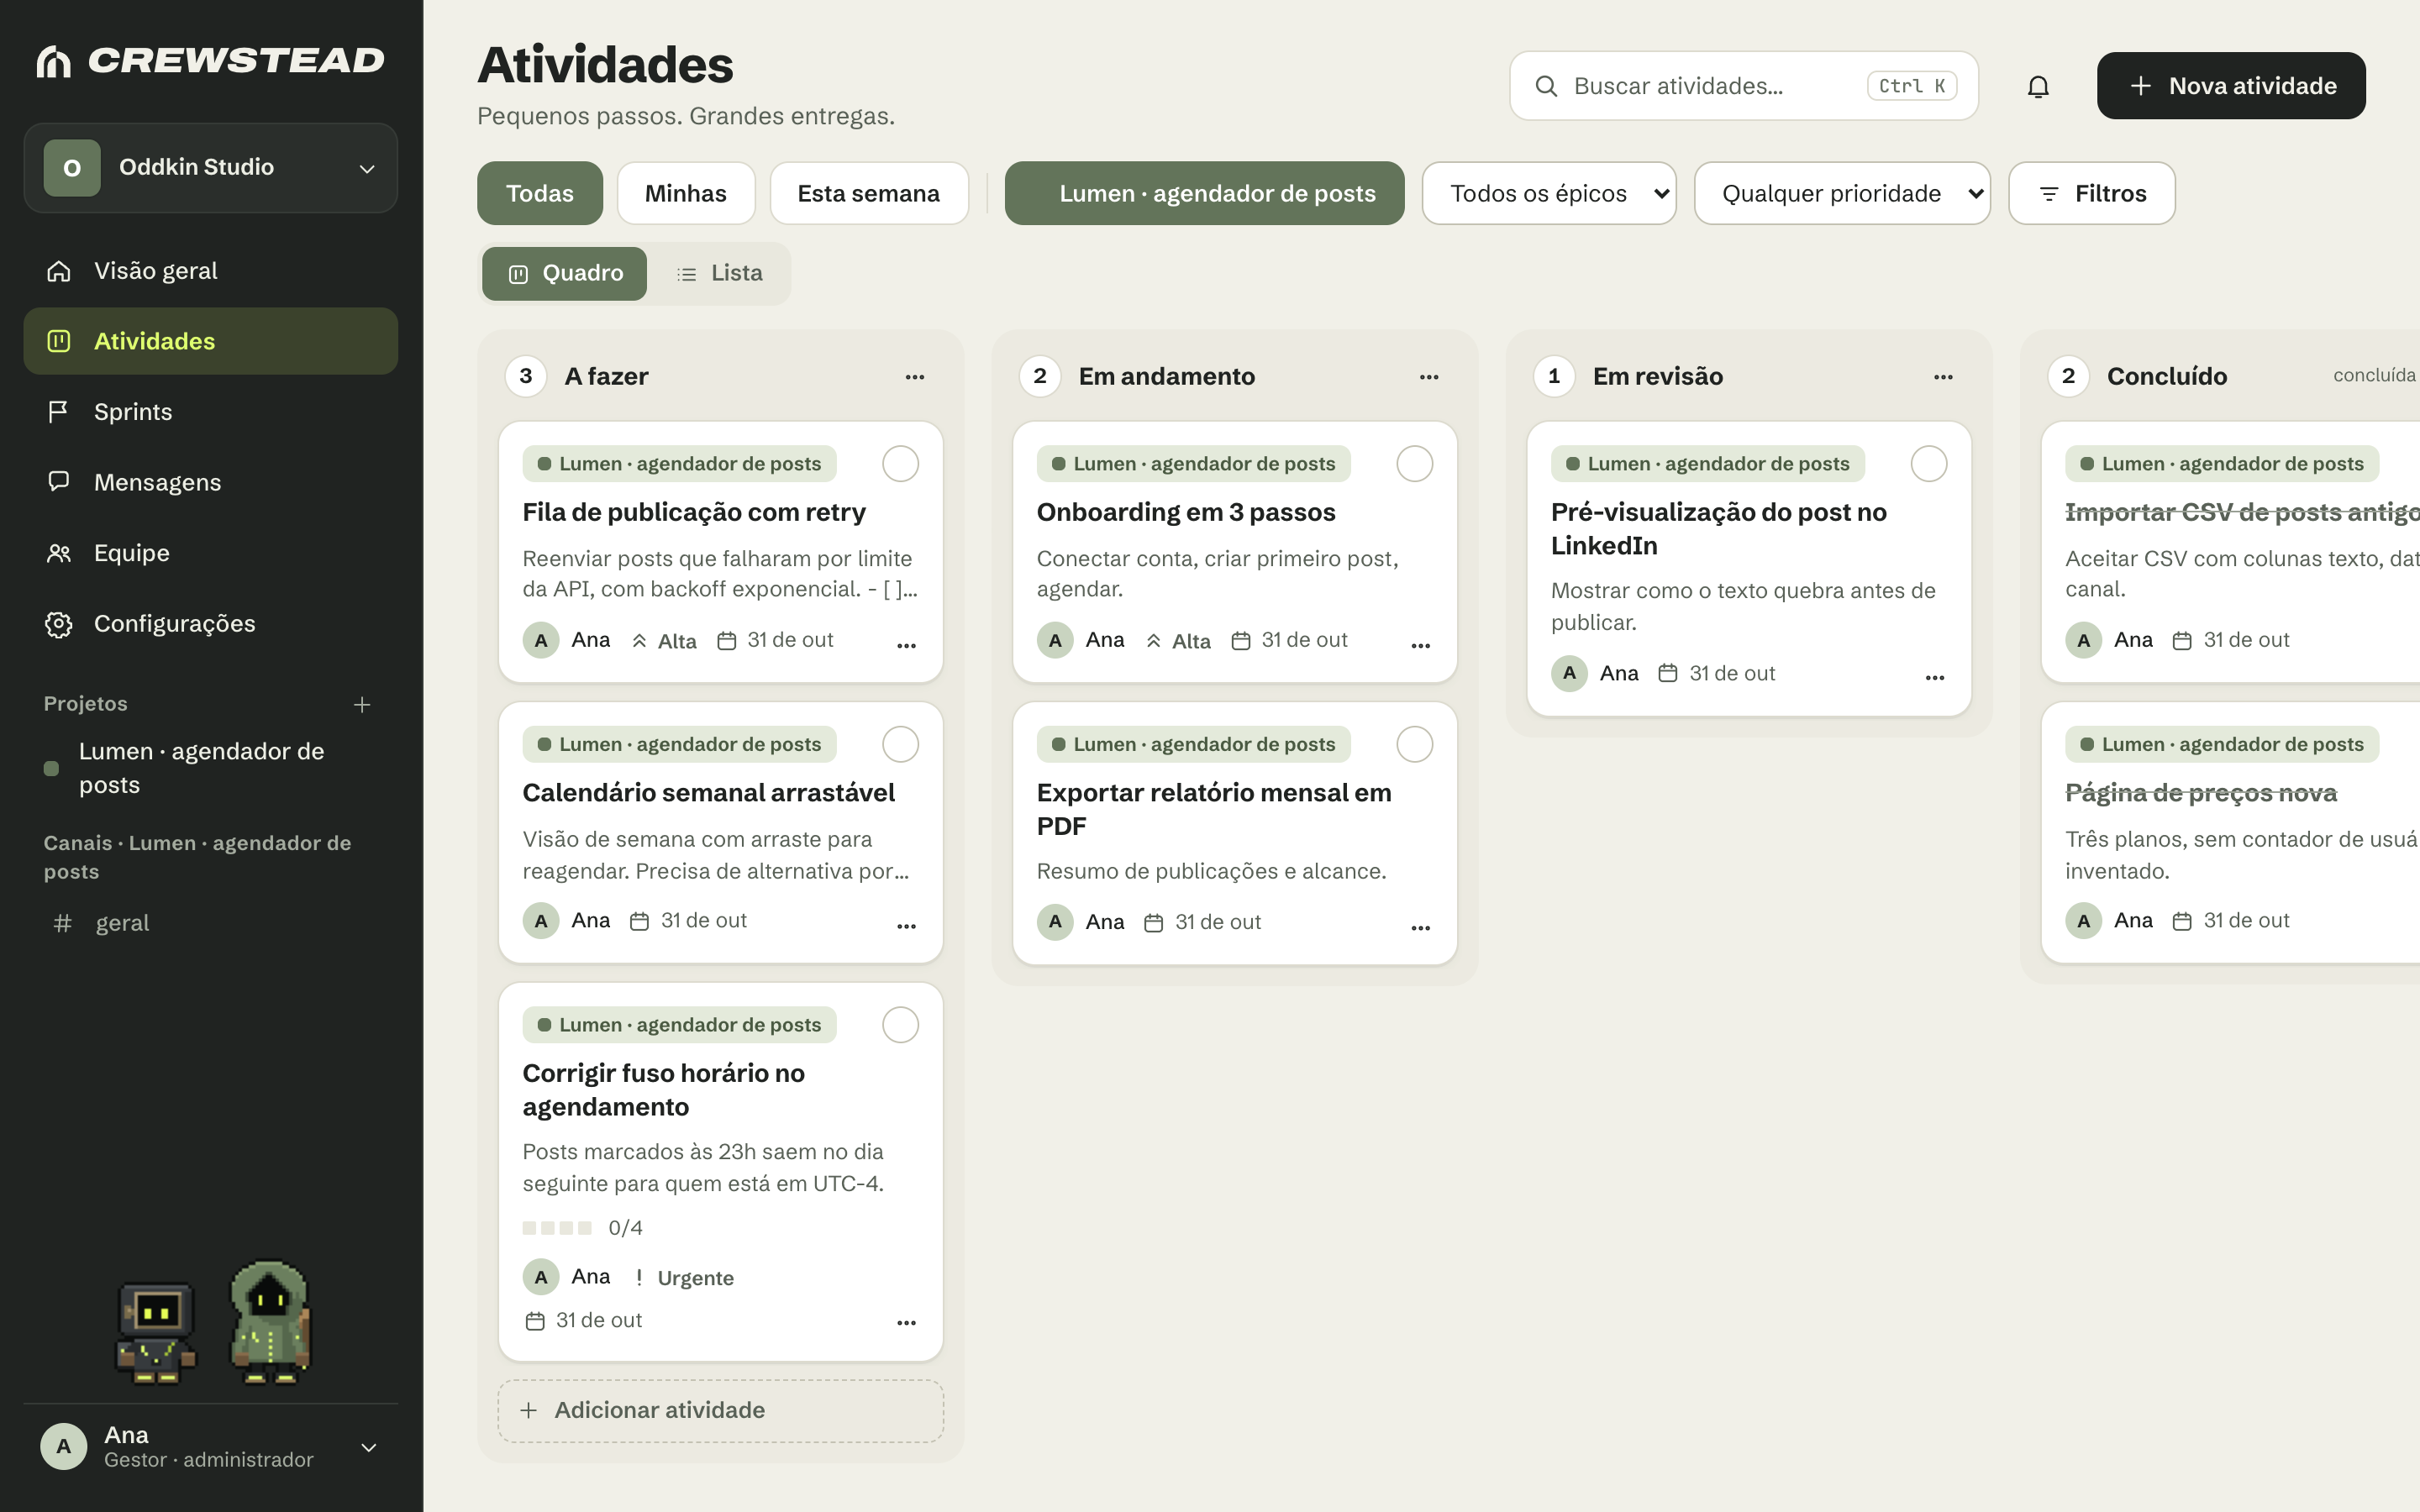
- Quadro de atividades com épicos, subtarefas, responsáveis, prazos e colunas que você configura;
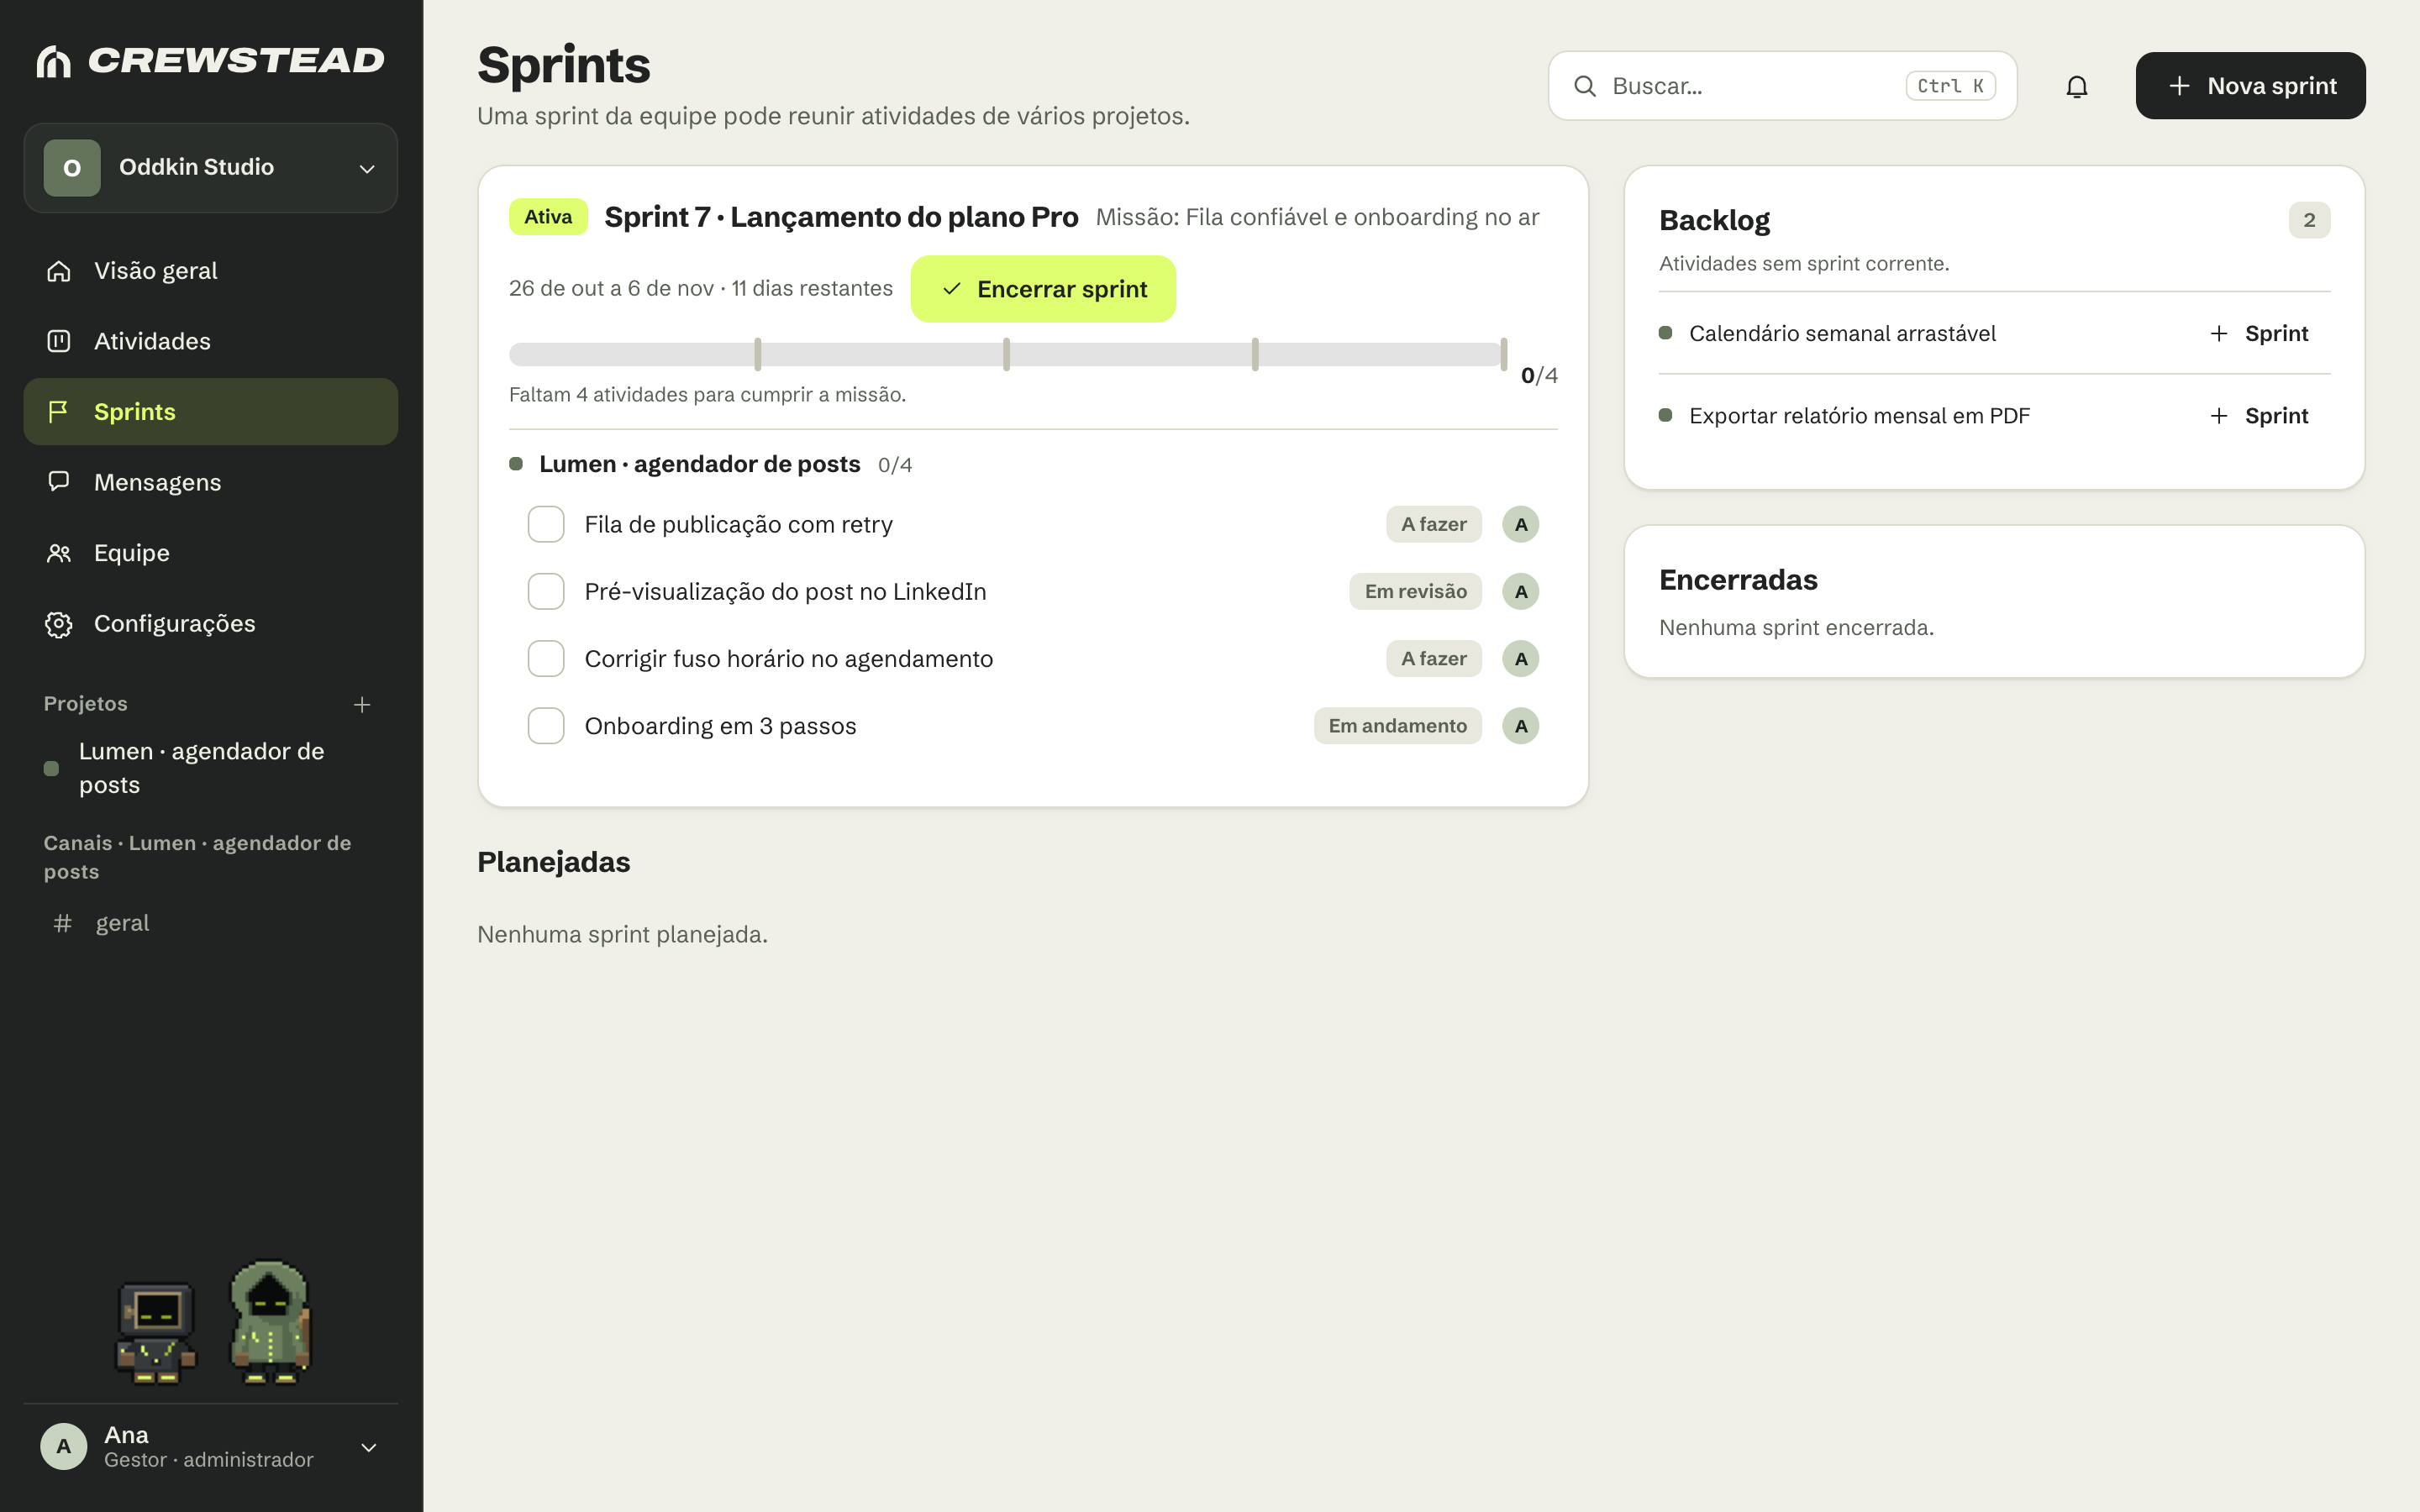
- Sprints da equipe, que podem juntar atividades de projetos diferentes;
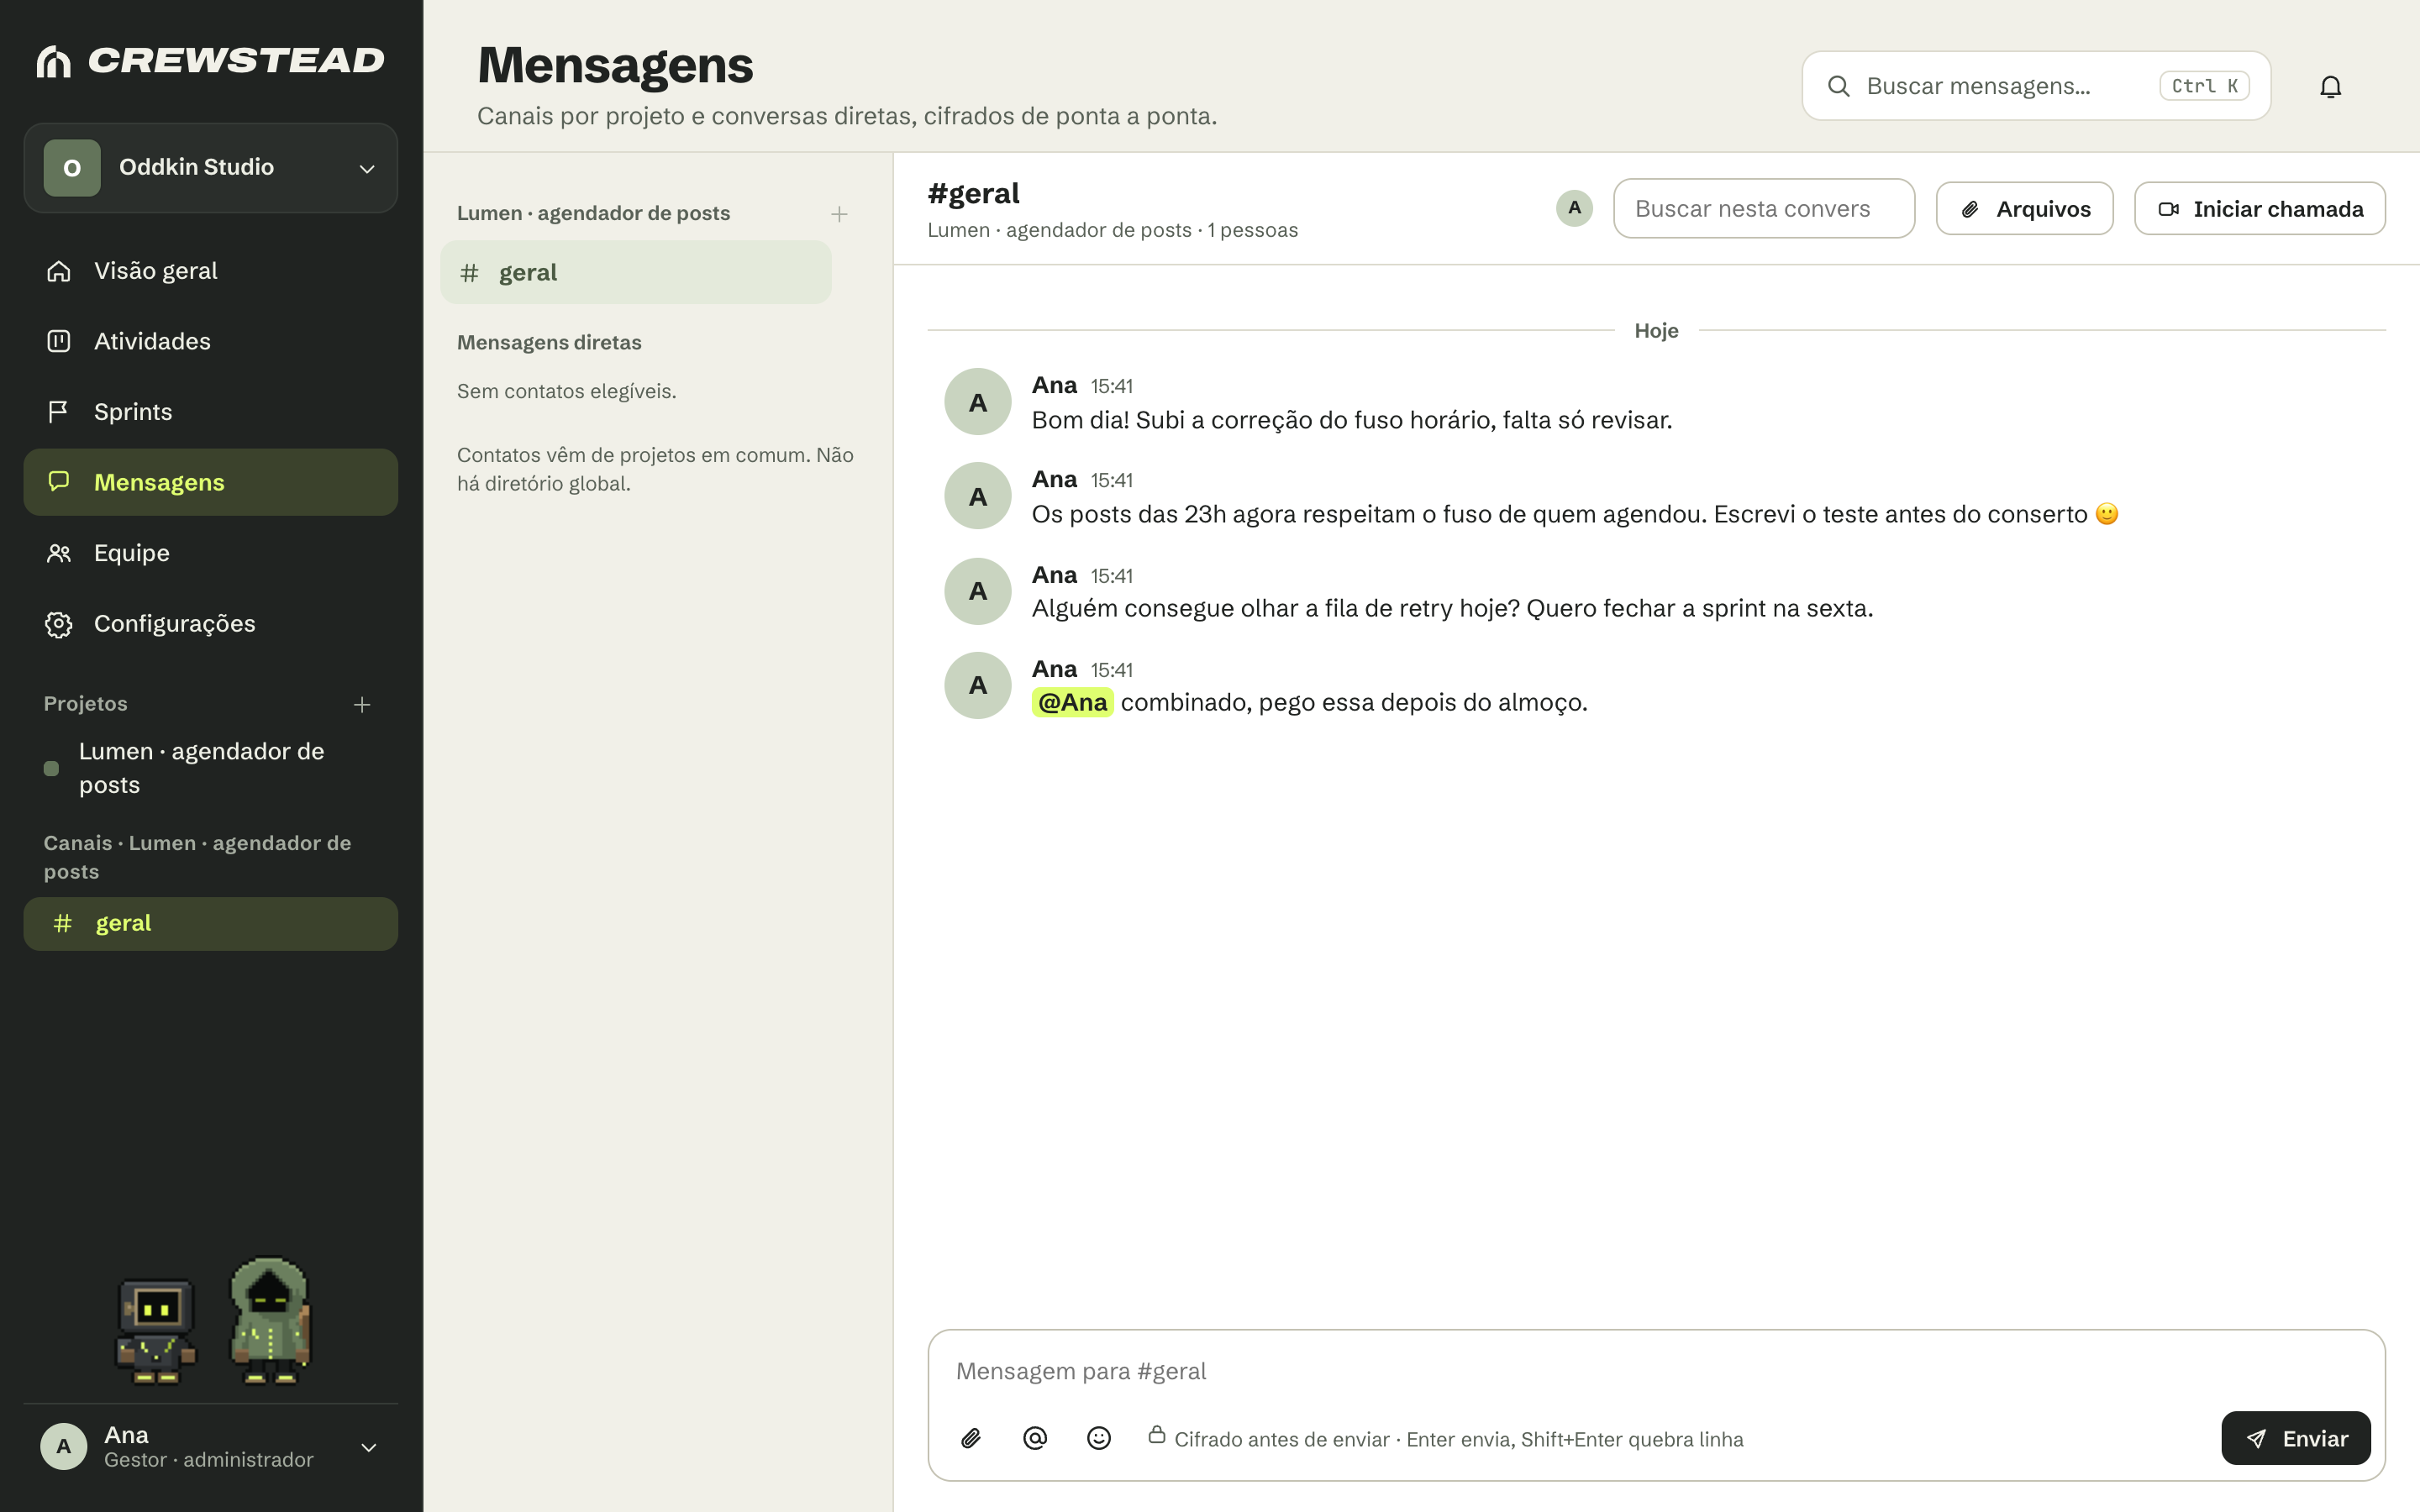
- Canais por projeto e mensagens diretas, com menções, reações e respostas;
- Chamadas de áudio, vídeo e tela para até 5 pessoas (LiveKit, também self-hosted);
- Anexos de até 500 MB, enviados direto do navegador para um bucket compatível com S3 (R2 em produção, MinIO local);
- Colaboradores externos com acesso só aos projetos liberados;
- Dois personagenzinhos em pixel art, o Capuz e a Tela, que aparecem nos estados vazios e comemoram quando você entrega algo. Sem pontos, sem ranking, sem competição. Só uma comemoração discreta.
O slogan é "Pequenos passos. Grandes entregas.", e é basicamente o espírito do projeto.
O ponto central: auto-custódia de verdade
Essa é a parte que me move, então vou ser direto.
O conteúdo de trabalho (título e descrição das atividades, comentários, mensagens, nomes de projetos, canais e sprints, arquivos) é cifrado no navegador, antes de sair dele. O servidor guarda só texto cifrado. As chaves são geradas e ficam no seu dispositivo (libsodium, rodando em workers). Você continua entrando só com a senha da conta, não tem uma segunda senha para decorar.
Eu não quero que você acredite em mim, então vou mostrar. Isto é o que o banco de dados da instância de demonstração tem guardado das mensagens e das atividades que aparecem nos prints:
 title |                     title_enc                     | priority | encrypted
-------+---------------------------------------------------+----------+-----------
       | 0101000000018aed03c64f702e24790ca534c698c6ec67ec… | high     | t
       | 010100000001a38d170888a6df54fa1770c59c8e25a6c387… | normal   | t
       | 01010000000128d7982bbc3c6e2bca1974fd8dbc6ec4c10d… | normal   | t
       | 010100000001abf29e9cd8ac3fcc86534bba91fee4dbff49… | urgent   | t

 seq | body |                     body_enc                      | encrypted
-----+------+---------------------------------------------------+-----------
   1 |      | 010100000001fac0bb81c955593460f9bad86fb4cf037c78… | t
   2 |      | 010100000001df62a7f0ef0873a30b837a7b7ea20e4fa3d7… | t
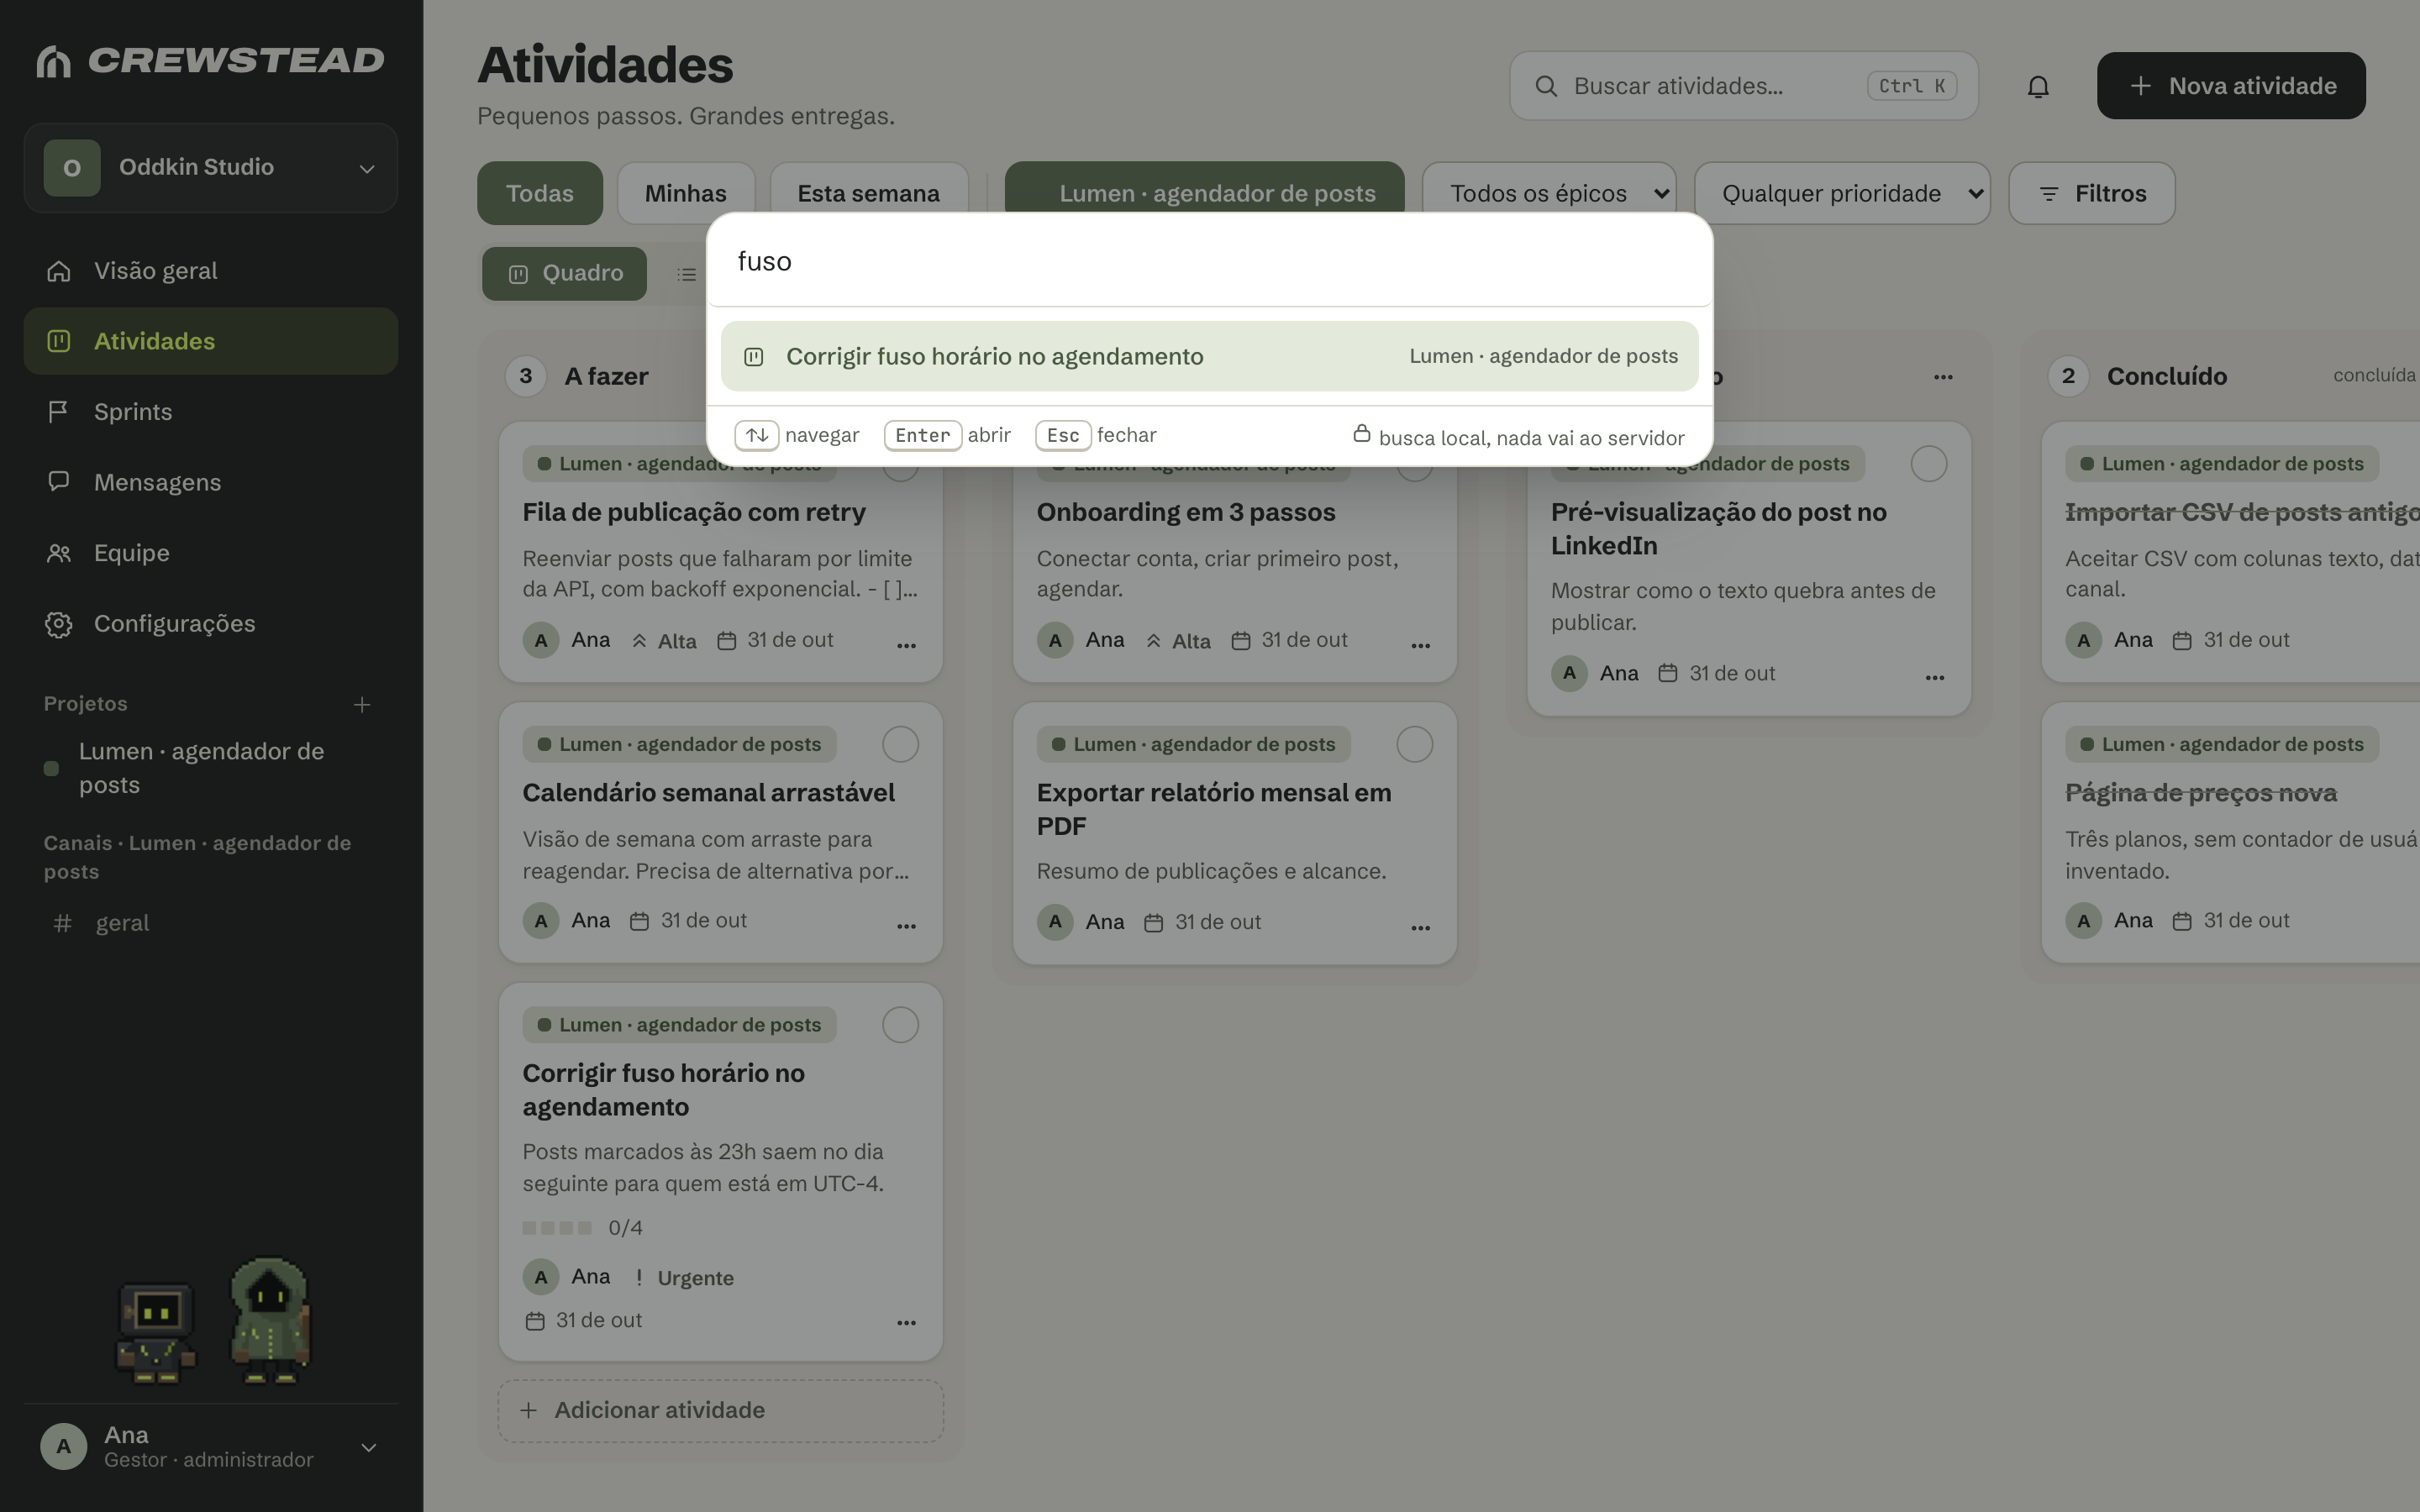
Colunas title e body vazias. O que existe é title_enc e body_enc. Até a busca (o Ctrl K) roda local no navegador: a própria paleta avisa "busca local, nada vai ao servidor".
O que o servidor ainda enxerga (sem enrolação)
Segurança que esconde as próprias limitações não é segurança. Então:
- O servidor vê metadados operacionais: seu e-mail, o nome de perfil, a prioridade de cada atividade (repare na coluna
priorityaí em cima), datas, quem está em qual projeto, tamanho dos arquivos. - Existe um administrador de recuperação. Ele pode decifrar conteúdo, inclusive mensagens diretas. Isso é uma decisão consciente: sem isso, perder o dispositivo significaria perder o histórico. A ação é explícita, local e auditada, e a própria tela avisa que o produto não é privado contra esse papel. A chave dessa identidade fica fora do servidor, num backup protegido por um segredo forte que você guarda longe da VPS.
- Se todos os dispositivos e o segredo de recuperação se perderem, o histórico pode ficar irrecuperável. Não tem chave-mestra escondida.
- Reset de senha sozinho não devolve as chaves do histórico. Um dispositivo novo precisa ser autorizado criptograficamente.
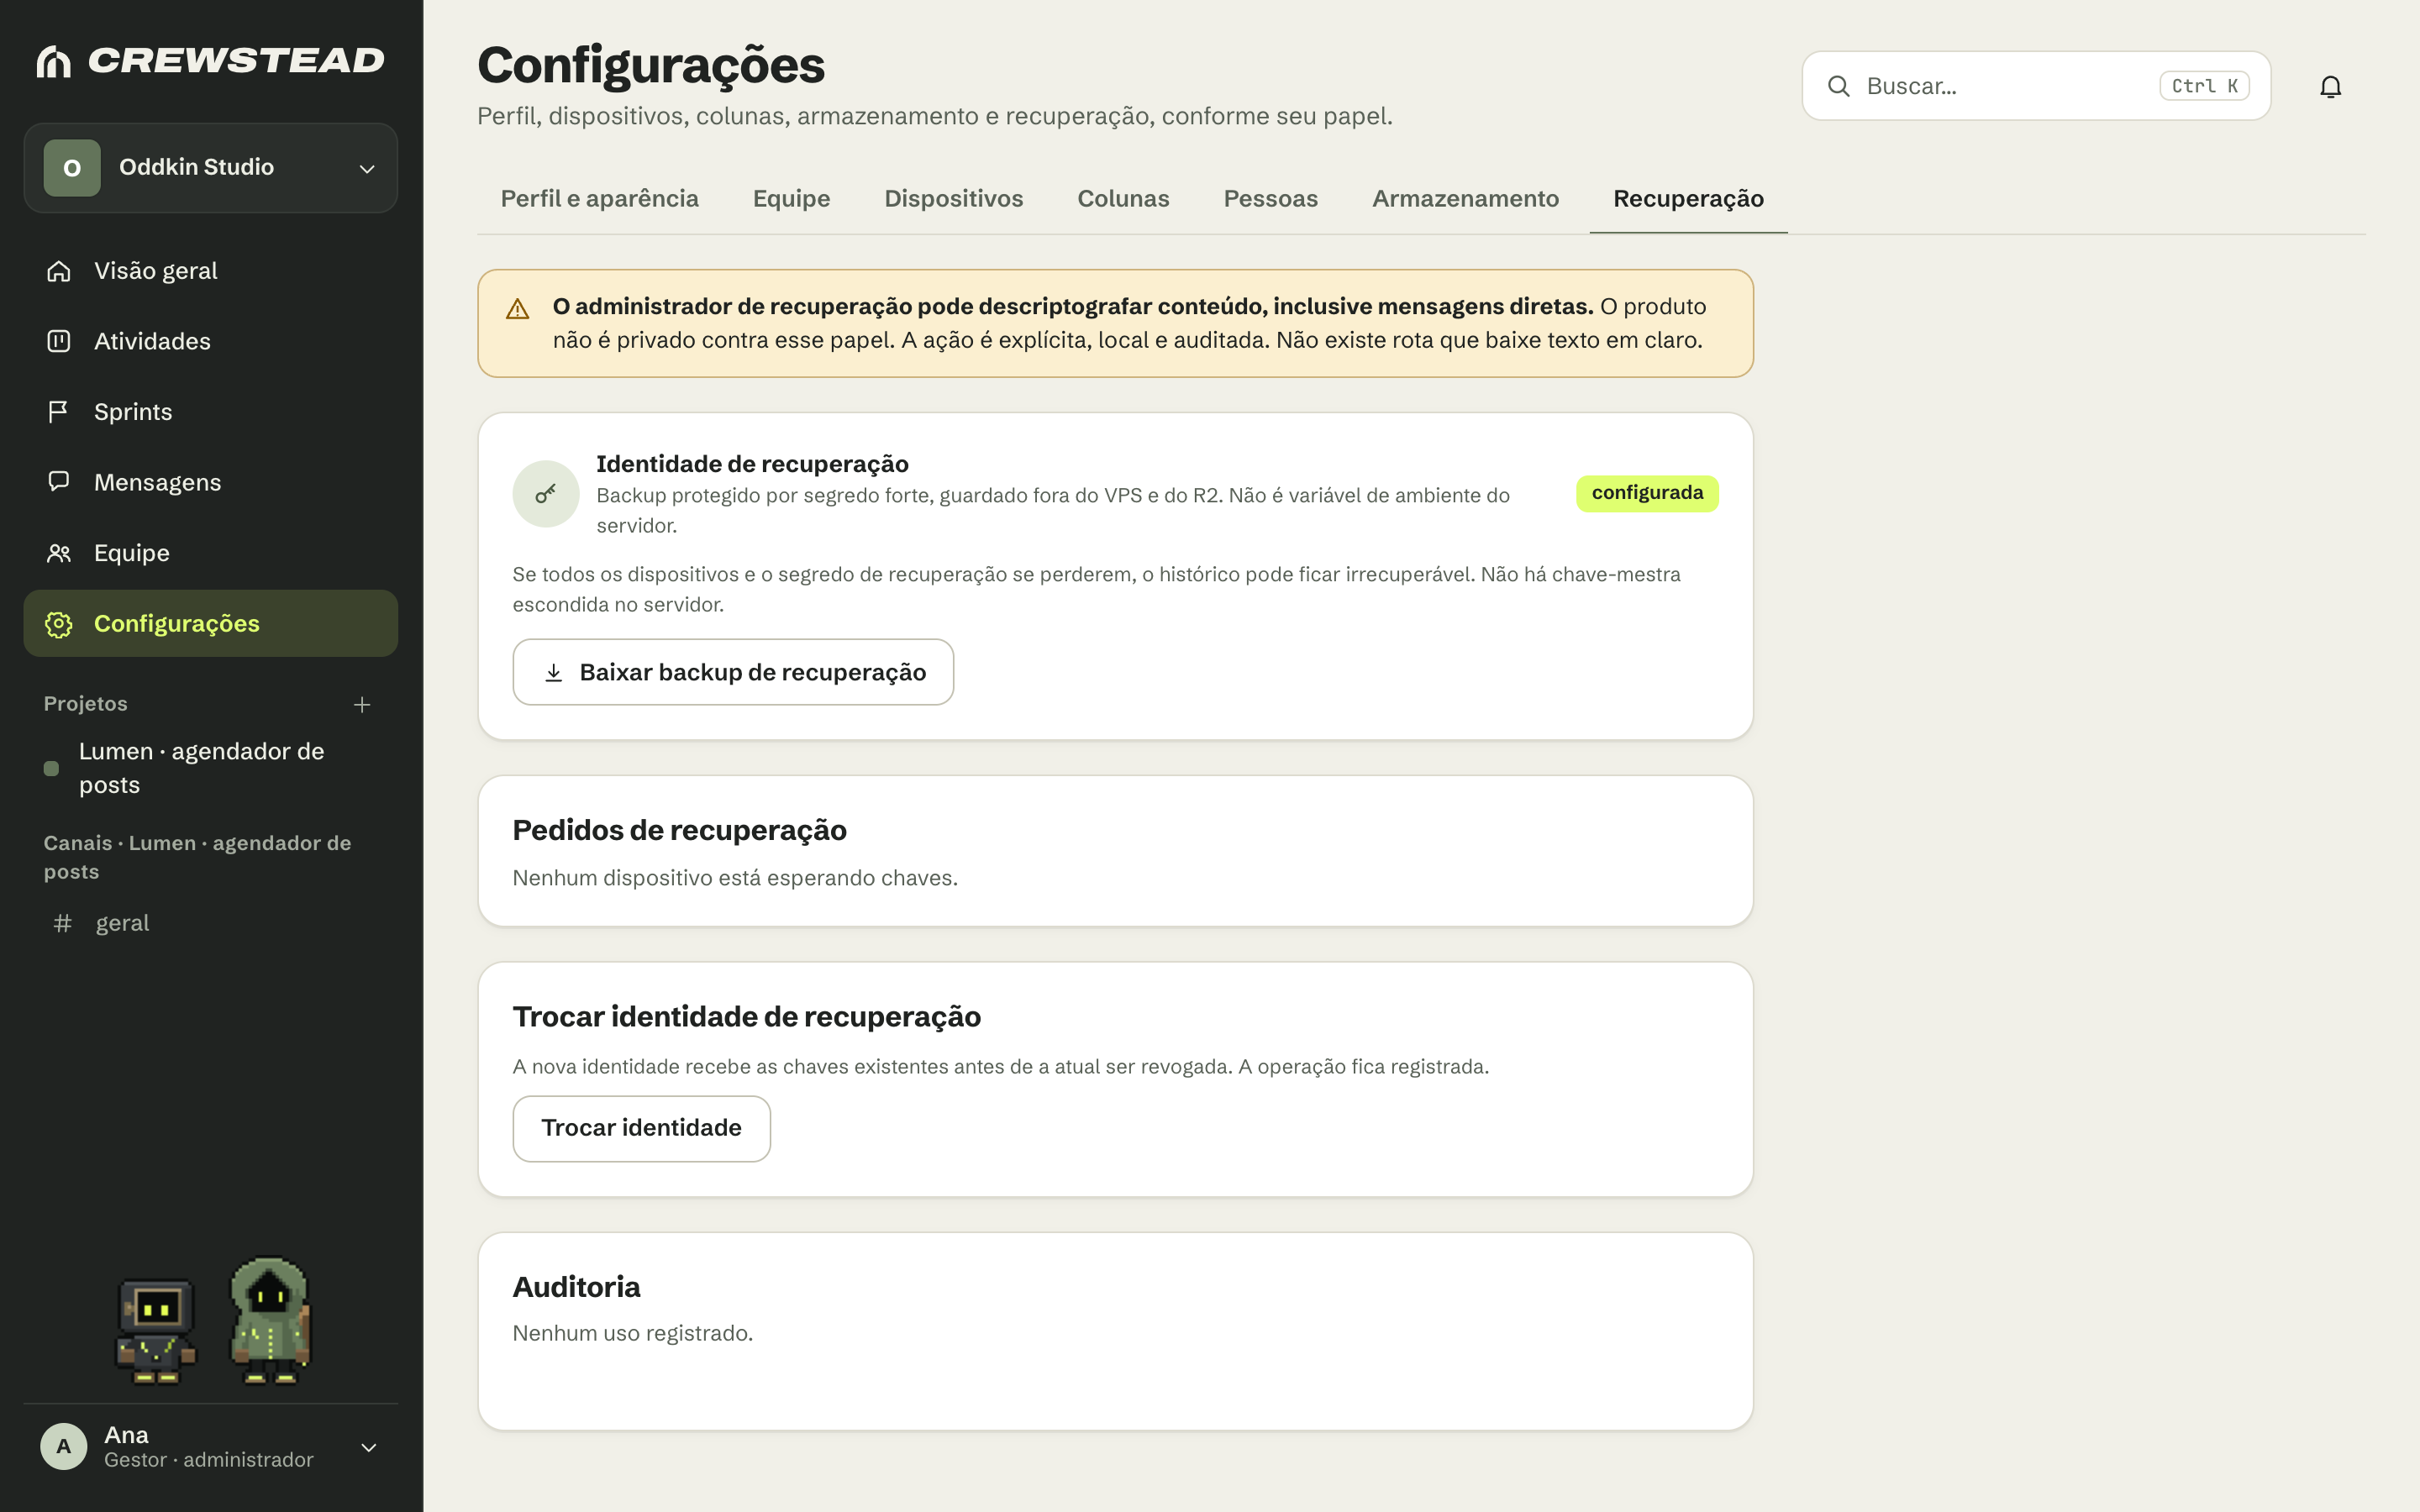
Tudo isso está escrito em uma spec e em ADRs (registros de decisão) no repositório, não só na minha cabeça.
Como ficou na prática
Segue um vídeo curto (em loop) com um fluxo real: abrir uma atividade, comentar, concluir (o Capuz aparece), ver a sprint andar e mandar uma mensagem. Tudo isso cifrando por baixo.
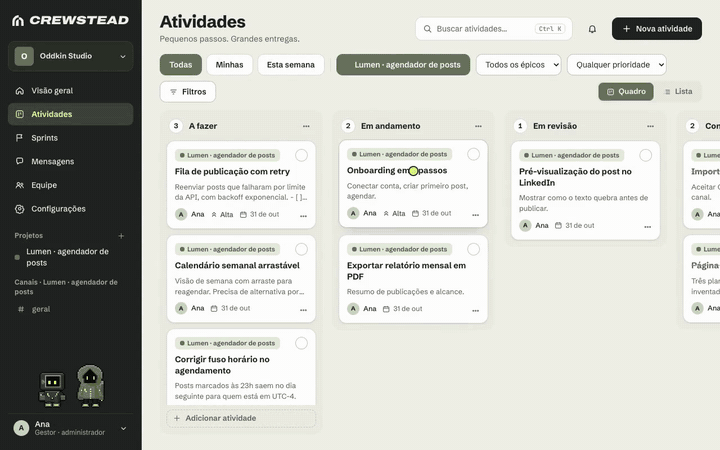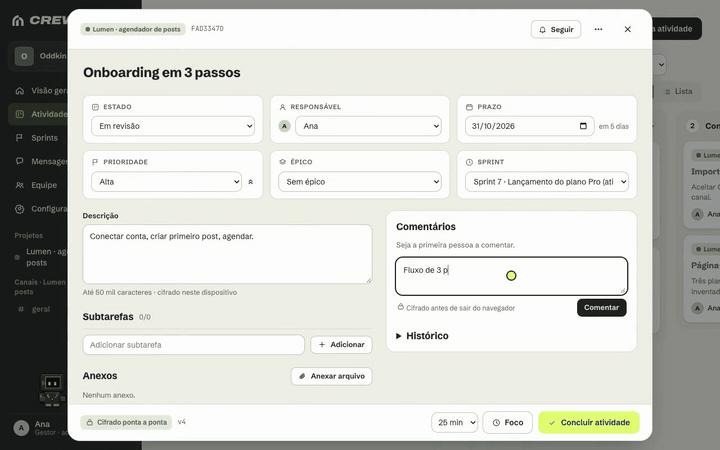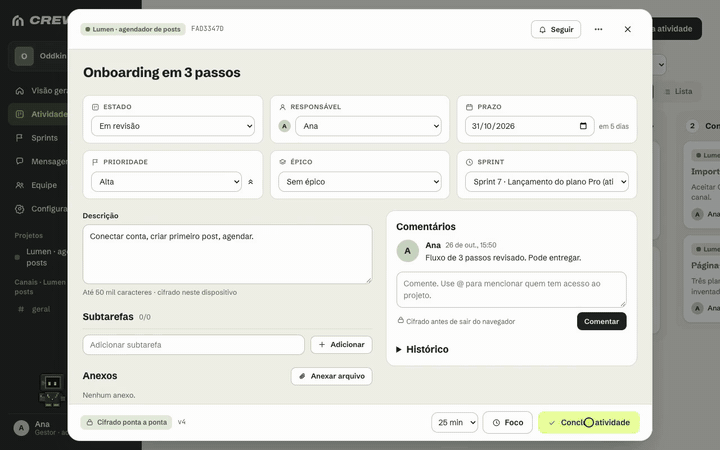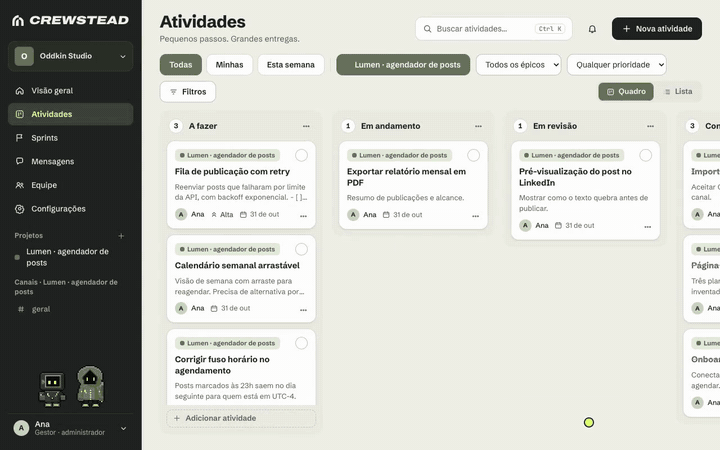
Versão em vídeo completa (45 s): demo.mp4
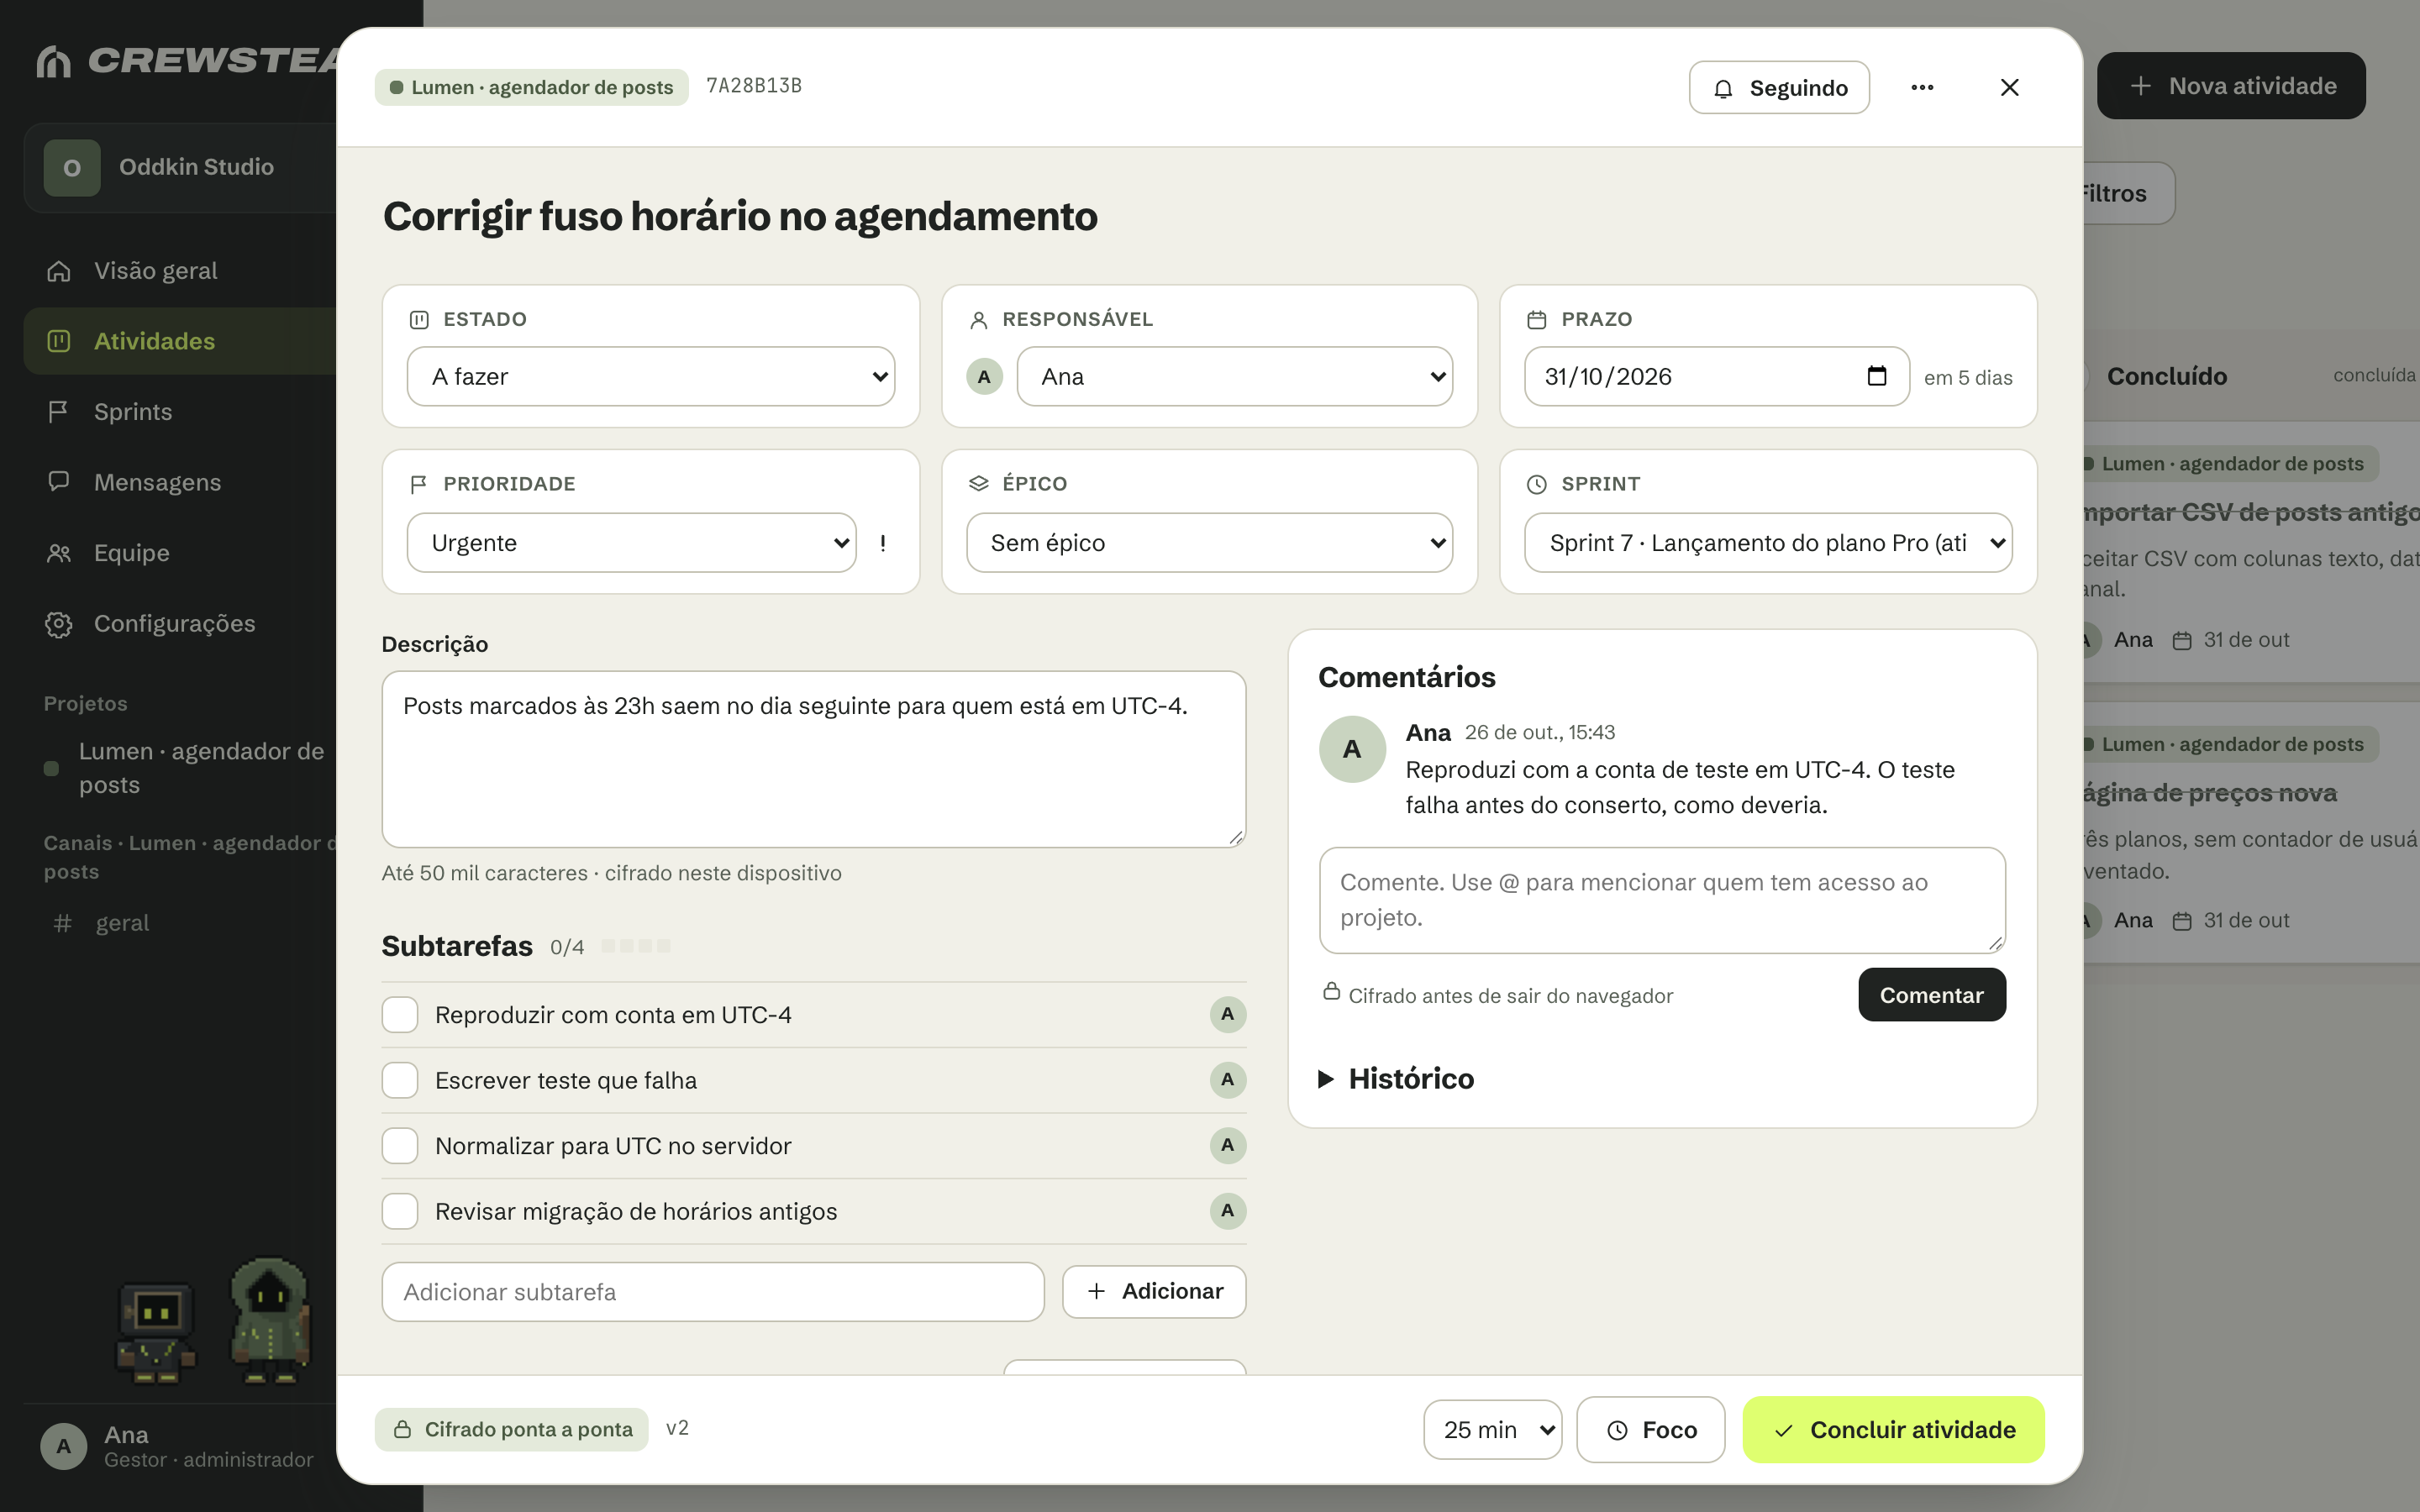
A atividade aberta, com subtarefas, comentários e o selo de que é cifrada ponta a ponta:
A sprint, juntando atividades do time:
Canal do projeto:
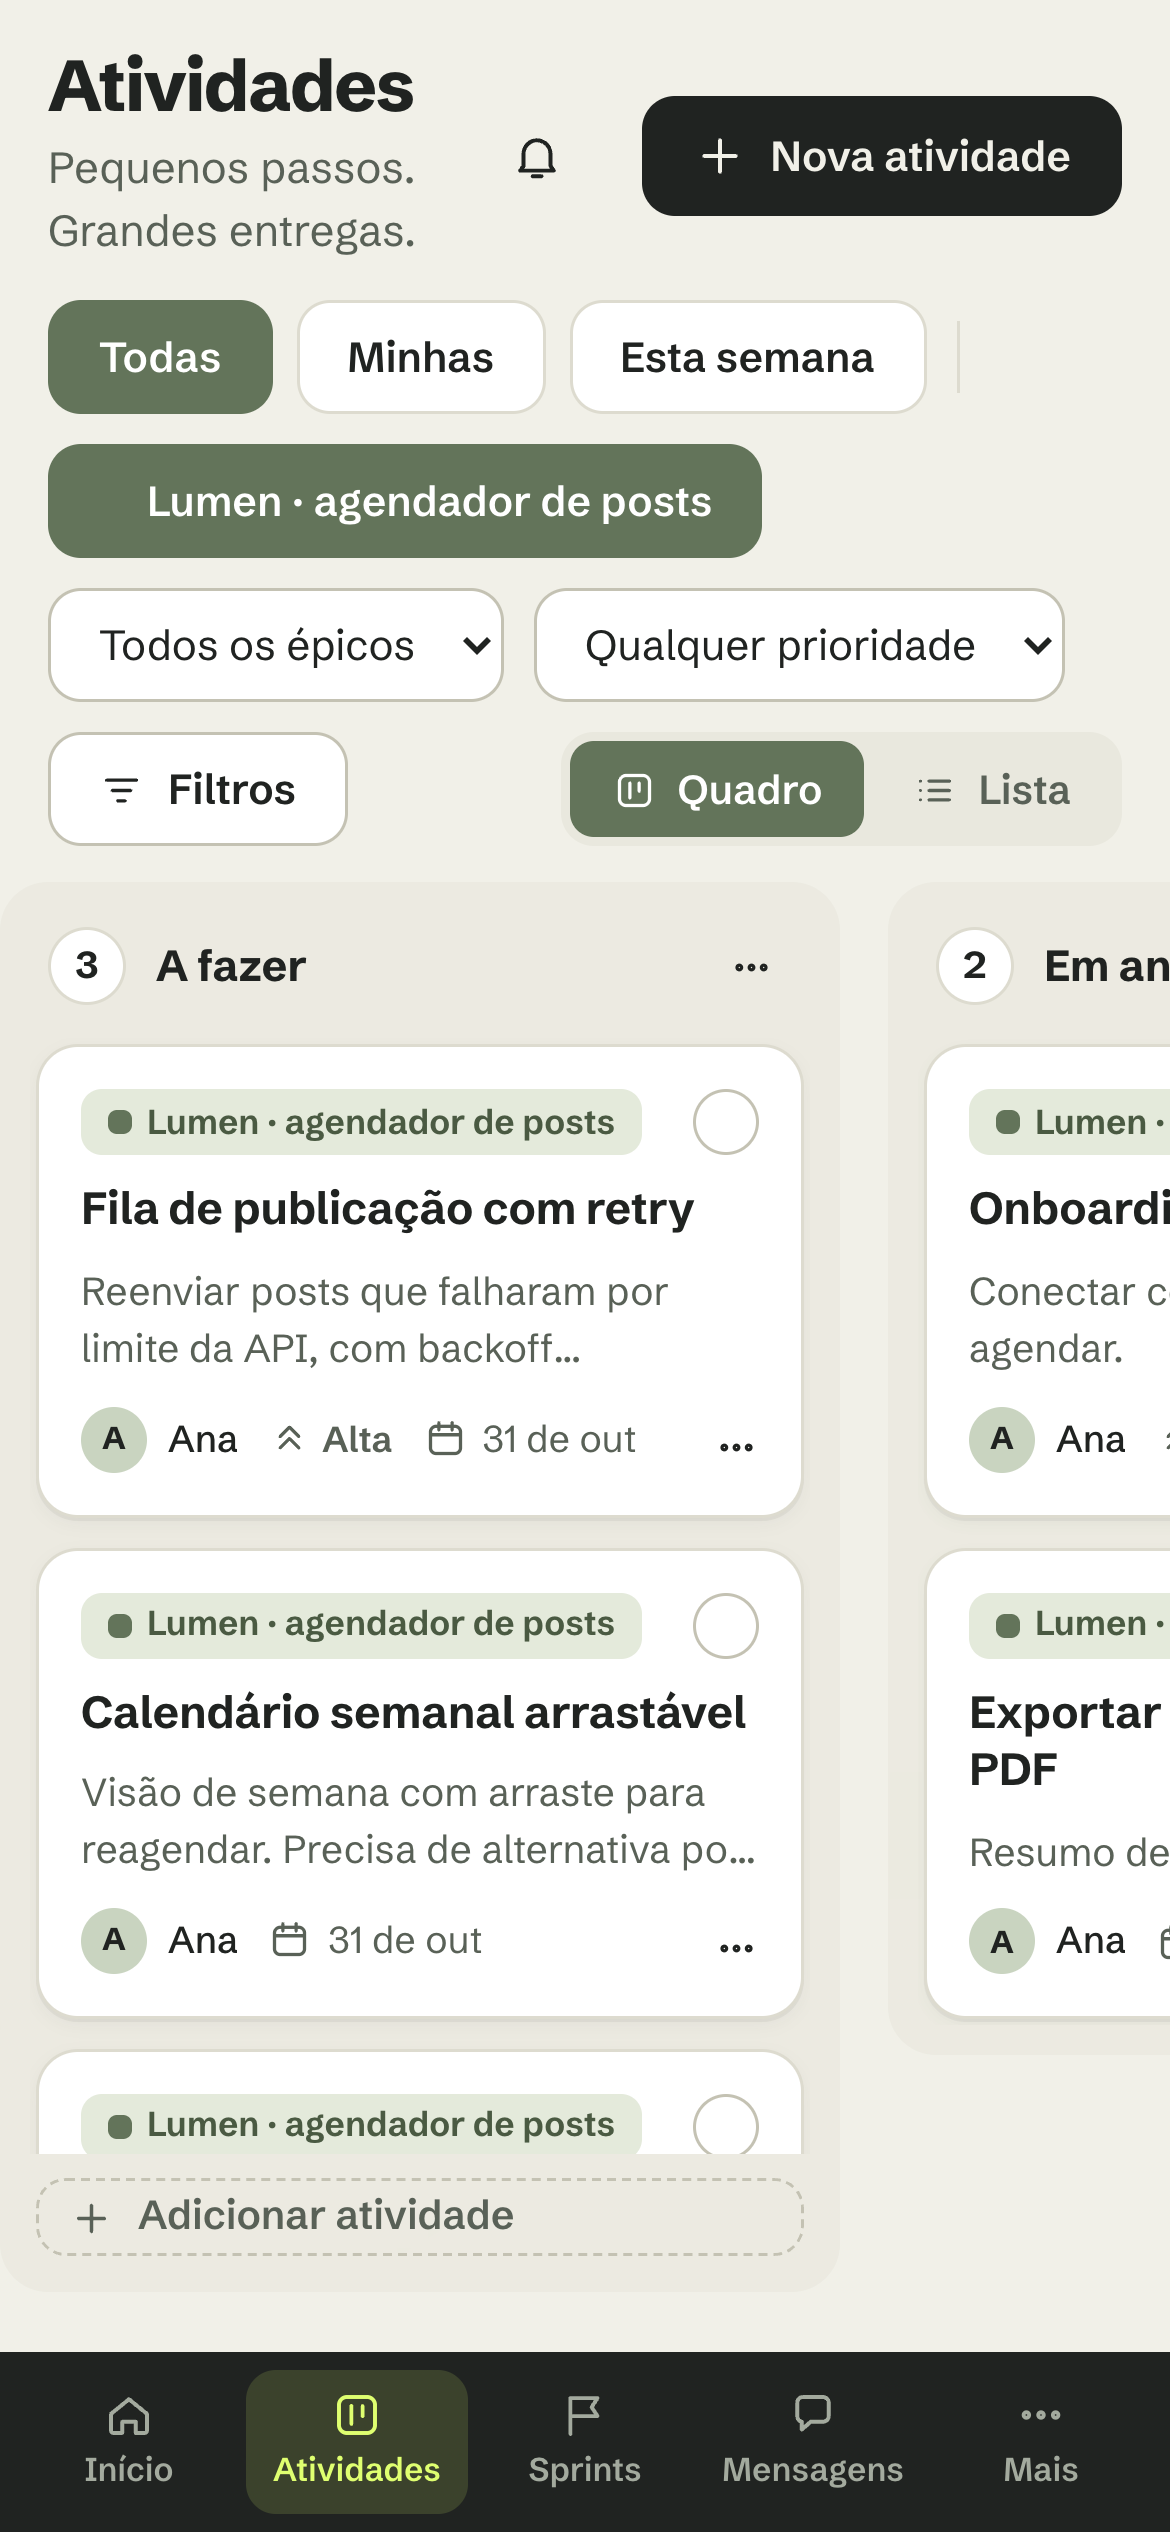
Tem tema escuro e funciona no celular (barra inferior em vez da lateral). Teclado, foco, contraste e a opção de reduzir animações foram tratados desde o começo, e arrastar cartão não é o único jeito de mover uma atividade: o menu do cartão também move.
Por baixo do capô
- Backend: Go,
net/http, um monólito modular. Um único processo faz HTTP, migrations, bootstrap do administrador e os jobs. - Banco: PostgreSQL com pgx e sqlc. Jobs com River, usando o próprio Postgres (sem Redis, sem broker).
- Contrato: OpenAPI 3.0.3, com código Go e cliente TypeScript gerados. Eventos em tempo real por WebSocket; escrita sempre por REST.
- Frontend: React, TypeScript strict, Vite, Tailwind, Radix, TanStack Query.
- Chamadas: LiveKit self-hosted, com a mídia também cifrada ponta a ponta.
- Operação:
make starte pronto. Docker Compose com cinco serviços:postgres,api,livekit,storageeweb.
Foi uma escolha deliberada ficar pequeno: nada de microsserviços, Kubernetes ou ORM extra. A ideia é que uma pessoa consiga subir, entender e manter numa VPS barata.
Como você pode ajudar
Dá para ajudar de formas bem diferentes, de acordo com o tempo que você tem:
- Dar uma estrela no repositório. Parece pouco, mas é o que ajuda o projeto a ser encontrado.
- Me seguir no GitHub, se quiser acompanhar a evolução.
- Ler a spec e os ADRs e criticar. Principalmente a parte de criptografia e recuperação. Se você trabalha com segurança, a sua revisão vale ouro, e eu agradeço até o "isso aqui está errado".
- Subir na sua máquina (
make start) e me contar onde travou. Experiência de instalação é o que mais quebra em projeto self-hosted. - Abrir issues com sugestão de escopo, bug ou estranhamento na interface.
- Contribuir com código. As regras estão no
CLAUDE.mde na spec. Cobertura de testes do frontend é um ótimo começo.
E eu tenho algumas perguntas para vocês, nos comentários:
- Um administrador de recuperação explícito e auditado é um trade-off aceitável para uma equipe pequena, ou vocês prefeririam não ter essa capacidade e aceitar perder histórico?
- O que faria vocês largarem o que usam hoje (Slack, Linear, Discord, Notion...) e testarem uma coisa assim? E o que seria um impeditivo?
- Faltou alguma coisa que equipe de microSaaS usa todo dia?
Repositório: https://github.com/GuilhermeVgl/oddkin-comms
Se você chegou até aqui, obrigado de verdade. Qualquer feedback, até o duro, é bem-vindo.