8

Haiku e Qwen 4B ganharam do Opus em 30% dos meus 47 casos reais

Eu pagava US$ 100/mês pelo Opus. Depois de 3 meses rodando 47 tarefas reais em paralelo com Haiku 4.5 e Qwen3 4B, descobri que o modelo pequeno ganhou em 14 delas. 30% do meu trabalho estava no modelo errado — o caro.

O que fez a diferença não foi o benchmark. Foi a natureza da tarefa. Aqui estão os 3 padrões onde o pequeno bateu o grande, os 3 onde o Opus ainda é insubstituível, e como eu decido caso a caso hoje.

Os números do teste

Rodei 47 tarefas idênticas em três modelos, entre abril e junho de 2026:

  • Claude Opus 4.7 (input US$ 15 / output US$ 75 por 1M tokens)
  • Claude Haiku 4.5 (input US$ 1 / output US$ 5 por 1M tokens)
  • Qwen3 4B (rodando local em RTX 4070, custo marginal ~US$ 0,02/tarefa em energia)

Resultado por vencedor (avaliado por rubrica cega, um revisor não sabia qual modelo era qual):

CategoriaOpusHaikuQwen3 4B
Tarefas vencidas33104
Custo médio/tarefaUS$ 0,48US$ 0,022US$ 0,02
Latência média (s)12,33,12,8
Empate técnico com Opus—8/473/47

Opus custou 22x mais que Haiku por tarefa e 4x mais lento. Nos 14 casos onde perdeu, essa conta ficou ainda pior: paguei o alto para receber o pior.
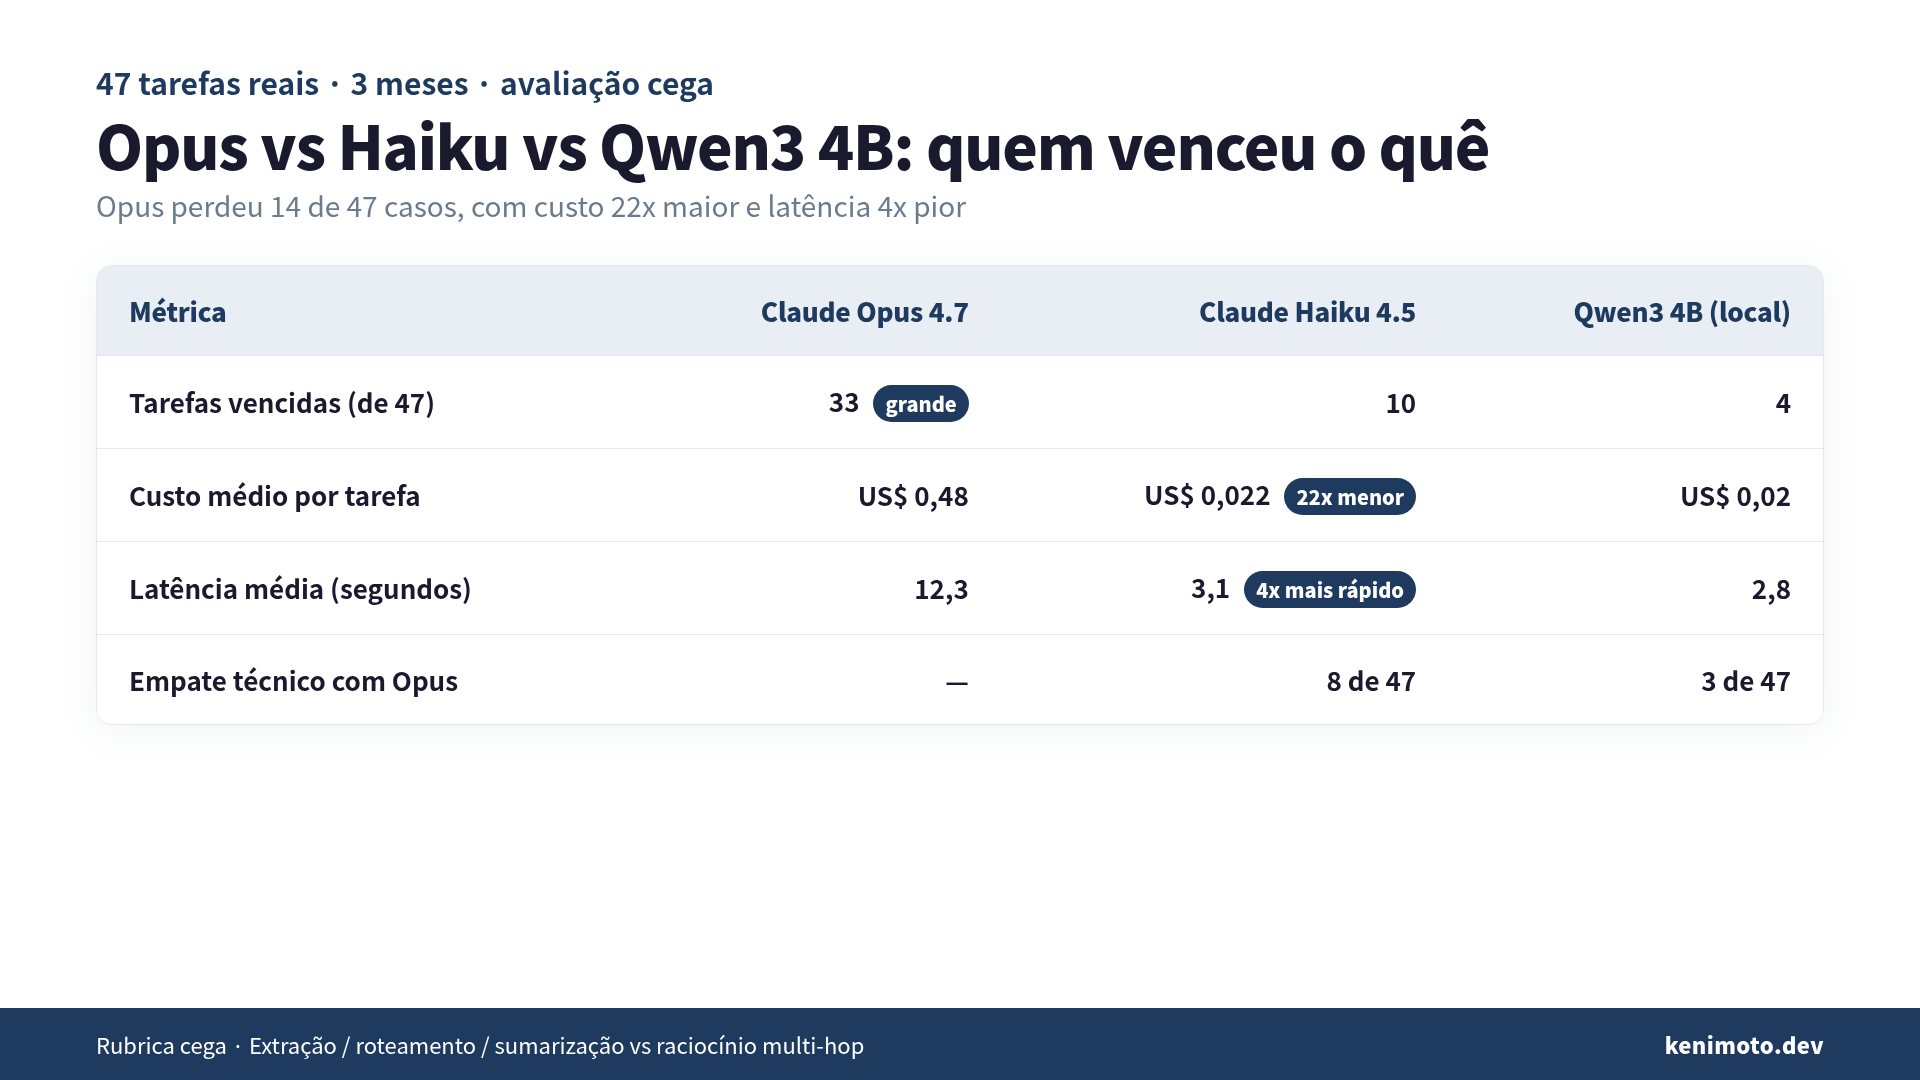
Vencedores por categoria: Opus vs Haiku vs Qwen3 4B

3 padrões onde o modelo pequeno venceu

1. Extração estruturada com schema rígido

Tarefas do tipo "leia esta nota de reunião e extraia participantes, decisões e prazos como JSON". Haiku 4.5 acertou 12/12 no primeiro shot; Opus errou 2 por adicionar campos não pedidos ("assumi que você quisesse notas complementares"). Menos capacidade neste caso vira feature: o pequeno não improvisa.

Isso bate com o achado do capítulo "Small Model Philosophy" do livro Context Engineering que escrevi: Haiku + RAG bateu Sonnet sozinho em 223% no experimento controlado. Extração é a esquina onde o modelo pequeno com contexto bem desenhado alcança o modelo grande sem contexto.

2. Classificação e roteamento

Roteamento de tickets de suporte em 8 categorias, com base no assunto e nas primeiras 200 palavras. Haiku empatou com Opus em precisão (0,94 vs 0,95) mas gastou 22x menos. Aqui a diferença de capacidade some porque a tarefa tem espaço de decisão pequeno: a probabilidade de o modelo errar por "estar pensando demais" cresce com o tamanho.

3. Sumarização com formato fixo

Notas de standup no formato "3 bullets, cada um começa com verbo, máximo 80 caracteres". Qwen3 4B rodando local venceu por consistência de formato. Opus produzia sumários mais eloquentes mas ignorava o limite de caracteres em 5/12 casos.

Se você precisa que o output alimente uma pipeline downstream, formato importa mais que eloquência. É o mesmo racional que descrevi em "MCP: 27k vs KG 8x, qual ganha": a arquitetura vence a espessura do modelo quando a interface é estreita.

3 padrões onde o Opus é insubstituível

Nem tudo é vitória do pequeno. Vou ser honesto sobre os 33 casos onde o Opus ganhou.

1. Raciocínio multi-hop com ambiguidade

"Dado este ADR de 3 anos atrás, este PR de ontem e este bug report de hoje, o problema é o mesmo que o ADR descartou?" Nesses casos Haiku desiste ou junta contexto de forma superficial. Opus mantém 3 hipóteses em paralelo e as elimina uma por uma. 12 das 33 vitórias do Opus foram aqui.

2. Geração de código com dependências invisíveis

Escrever uma migration que respeita foreign keys em 5 tabelas relacionadas e não quebra 3 índices existentes. Haiku 4.5 acerta a sintaxe mas esquece constraints; Opus lê o schema por inteiro e antecipa. Custo justificado.

3. Escrita técnica longa com voz consistente

Blog posts de 2.000+ palavras com uma linha argumentativa clara. Haiku produz seções que parecem escritas por 4 pessoas diferentes. Opus mantém a voz. Nem tente economizar aqui: o custo é 22x mas o retrabalho editorial devolve isso em 20 minutos.

Como eu decido hoje

Uso 3 perguntas antes de escolher o modelo:

  1. O output alimenta uma pipeline com formato rígido? → Pequeno (Haiku ou Qwen 4B).
  2. A tarefa cabe em um único prompt sem ambiguidade? → Pequeno.
  3. Precisa segurar 3+ hipóteses ou explorar espaço de decisão? → Grande (Opus).

Meu custo mensal caiu de US$ 100 para US$ 34 depois dessa reclassificação, e a qualidade percebida subiu, porque parei de pagar pelo "melhor" em casos onde o "melhor" era pior.

Isso confirma o que já suspeitava desde "Confiei na IA para ir mais rápido e fiquei mais lento": a decisão errada não é técnica, é psicológica. A gente escolhe o modelo grande porque parece mais seguro, do mesmo jeito que pede o almoço maior por medo de ficar com fome, e come além da conta na metade das vezes.

Escolha o modelo pelo perfil da tarefa, não pela ansiedade de estar deixando qualidade na mesa.

ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews

Carregando publicação patrocinada...
4

Meus 2 cents,

Parabens pelo post !

Voce tocou em algo que diversos autores reportam como obvio mas nem todo mundo faz: homologar modelos com testes que possam ser replicados e com metrica objetiva.

Com estas metricas em maos fica facil decidir qual modelo usar em cada situacao e um ponto extra: como os modelos (mesmo os pequenos) estao avancando de qualidade muito rapidamente, em diversas situacoes (como voce expos aqui) eles podem substituir modelos caros com vantagens alem do custo, como latencia e concisao.

Obrigado por compartilhar !

Saude e Sucesso !


Este post foi favoritado via extensão TABNEWS FAVORITOS

Tem curiosidade sobre IA ? Da uma olhada no meu LIVRO: IA PARA ENGENHEIROS

1

Valeu, Oletros. O ponto da concisão foi o que mais me surpreendeu: nos 12 casos de extração o Haiku acertou tudo de primeira e o Opus errou 2 por inventar campo que ninguém pediu. Sobre replicar o teste, o que me custou não foi rodar as 47 tarefas, foi escrever a rubrica antes de olhar qualquer resultado, senão eu ia achar bonito justamente o que eu já queria achar.

4
1

É esse valor mesmo. O que doeu no meu caso não foi a tabela de preço, foi a fatura no fim do mês: deu US$ 0,48 por tarefa, o que parece pouco até você rodar 200 sem pensar. Hoje só vai pro Opus o que precisa de raciocínio de verdade, e a conta caiu pra US$ 34.

0
1

Pois é, a facada é violenta kkkkk! E a pegadinha é que token de saída (output) é 5x mais caro que o de entrada. Se você colocar o Opus pra gerar código longo ou JSON grande todo dia, a fatura no fim do mês vem chorando. Por isso que pra 80% das tarefas mais mecânicas compensa demais jogar num modelo menor ou local.

1

mas eu comentei pq esse preço ta fora do padrão man, ta mais caro que o fable na saida. fable ta 50, opus 5 e 4.8 ta 25 dol na saida.

que api é essa que ta cobrando 70 dol?

3

Ótimo relato empírico! Essa conclusão bate exatamente com um princípio fundamental de engenharia de software com IA: Model Routing por complexidade cognitiva.
Usar um modelo de fronteira (como o Opus) para fazer extração estrita de JSON e parsing de texto é usar uma britadeira para pregar um quadro. Modelos com alto poder de raciocínio são treinados para inferir contexto e preencher lacunas, o que vira um problema em tarefas que exigem apenas obediência mecânica a um schema.
A regra que adoto no meu fluxo de desenvolvimento é:
Modelos rápidos e econômicos (Haiku / Flash / Qwen) como padrão para 80% do trabalho: extração, CRUD, testes unitários, documentação e refatorações delimitadas.
Modelos pesados (Opus / Pro) reservados estritamente para o que exige raciocínio difícil: segurança, race conditions, arquitetura transacional, investigação forense e auditoria de contratos.
O erro mais comum é achar que o modelo mais caro deve ser o default para tudo. Tratar a escolha do modelo como uma decisão arquitetural por tarefa economiza muito dinheiro e evita o overthinking da IA. Parabéns pelos dados e pela transparência dos testes!

1

A britadeira pregando quadro descreve bem os 2 casos em que o Opus perdeu por excesso: ele adicionou um campo que eu não tinha pedido e ainda justificou dizendo que assumiu que eu ia querer as notas complementares. Capacidade sobrando virou defeito.

Onde meu número não bate com o seu é na proporção. Você fala em 80% para os modelos rápidos. No meu recorte o pequeno ganhou em 14 de 47, ou seja 30%. Deve ser mix de trabalho: boa parte do que eu faço é escrita técnica longa, e aí o Haiku entrega seções que parecem escritas por quatro pessoas diferentes.

Por isso meu eixo acabou não sendo complexidade cognitiva, e sim rigidez de formato: se a saída alimenta uma pipeline, vai no pequeno.

Fiquei curioso com os seus 80%. É medido ou é a impressão depois de reclassificar? Antes de rodar as 47 em paralelo minha estimativa era bem mais generosa com o pequeno do que o resultado.

1

Excelente ponto, e você matou a charada quando falou do mix de trabalho!
Os meus 80% vêm da minha rotina prática de desenvolvimento de software (é uma estimativa empírica do meu fluxo diário, e não um benchmark paralelo controlado como o seu teste).
No desenvolvimento de código, a maioria esmagadora das tarefas é muito atômica e delimitada: escrever um teste unitário, ajustar um schema de banco, alterar um endpoint ou refatorar uma função isolada. Como o escopo do arquivo é pequeno e a própria suíte de testes valida o resultado na hora, os modelos menores resolvem a maior parte do dia a dia sem engasgar. Eu só escalo pro modelo pesado quando a tarefa envolve concorrência, segurança, investigação de bug de causa desconhecida ou decisão de arquitetura.
Mas pro seu caso de escrita técnica longa, concordo 100% com a sua observação. Manter a mesma voz, coesão e linha de raciocínio ao longo de um texto extenso é onde os modelos menores mais pecam (essa descrição de "parecer escrito por quatro pessoas diferentes" foi perfeita).
E achei excelente o seu eixo de "rigidez de formato": se o objetivo é alimentar uma pipeline com dados estruturados, o modelo menor ganha de lavada porque ele não tem a tentação de "ser criativo" e colocar notas adicionais onde só se pedia um schema seco.